Jak zbudowaliśmy rozpoznawanie pisma dla 7 alfabetów
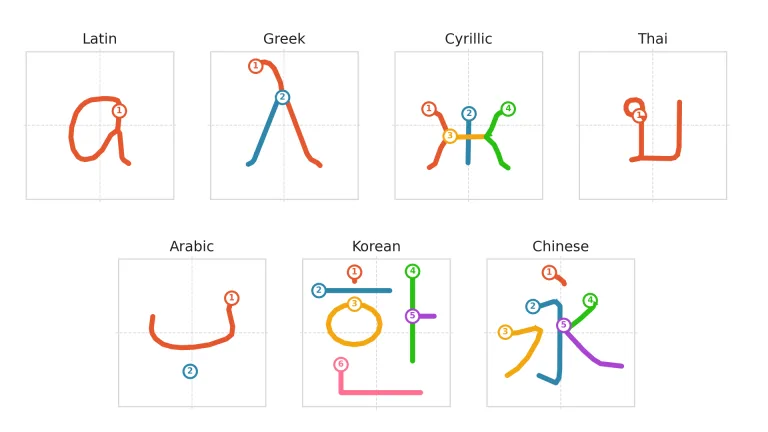
Zbudowaliśmy rozpoznawanie pisma, które sprawdza, jak uczniowie piszą litery i znaki w siedmiu alfabetach. Zaczęliśmy od dużego modelu językowego i porzuciliśmy go pierwszego dnia. Dziś działa mała sieć sekwencyjna, około 0,8 miliona parametrów na pismo, która czyta drogę twojego palca. Nad nią jest przejrzysty sędzia. Całość działa na naszych serwerach bez karty graficznej i odpowiada w 40–100 ms. W naszych testach przyjmuje 95–99% poprawnych rysunków w pięciu pismach i prawie nigdy nie myli znaku z podobnym. Oto jak do tego doszliśmy, razem z błędami.
Spis treści
- Czego ćwiczenie Pisanie potrzebuje od maszyny
- Podejście 1: zapytać duży model językowy
- Podejście 2: dopasować wzorce, a decyzję zostawić sędziemu
- Mała sieć do obrazów
- Od obrazka do drogi pióra
- Audyt: nasze liczby kłamały
- Sieć sekwencyjna, która zadziałała
- Jak nauczyć sieć mówić „to nie jest znak”
- Skąd dane do trenowania
- Trening na jednym laptopie
- Jak mierzymy i kiedy model wygrywa
- Wyniki dla każdego pisma
- Czego jeszcze nie umie
- Najczęściej zadawane pytania
Czego ćwiczenie Pisanie potrzebuje od maszyny
W ćwiczeniu Pisanie w Taalhammerze rysujesz znak palcem albo rysikiem, a aplikacja mówi, czy jest dobry. Brzmi jak rozwiązany problem. Telefony mają przecież klawiatury do pisania ręcznego. Ale klawiatura musi tylko zgadnąć, jaki znak miałeś na myśli. My musimy ocenić, jak go napisałeś.
Maszyna musi więc robić cztery rzeczy:
- Rozpoznać znak w alfabecie łacińskim, greckim, cyrylicy, tajskim, arabskim, koreańskim i chińskim.
- Odrzucić znak podobny. Napisane з, gdy zadaniem jest э, nie może przejść, nawet jeśli kształty są bliskie.
- Odrzucić rysunek niepełny albo zepsuty: brakującą kreskę, dodatkową linię, lustrzaną literę.
- Nigdy nie oblać cię za kolejność kresek. Może najwyżej o niej podpowiedzieć.
Ostatnia zasada wynika z badań. Pisanie liter ręcznie pomaga je zapamiętać dużo bardziej niż klawiatura czy samo patrzenie. Dorośli uczący się liter arabskich nazywali poprawnie 93% z nich po ćwiczeniu pisania, 86% po pisaniu na klawiaturze i 83% po oglądaniu (Wiley i Rapp, 2021). Pisanie odręczne działa lepiej niż obrysowywanie wzoru (James i Engelhardt, 2012). Dowody na to, że pomaga jedna konkretna kolejność kresek, są mieszane. Narzucona kolejność szkodziła bardzo małym dzieciom (Merritt i in., 2020), a animacje kolejności kresek obniżały rozpoznawanie u dorosłych uczących się chińskiego (Hou i Jiang, 2022). Dlatego w ćwiczeniu piszesz na pustej kratce, a nie po wzorze, a sprawdzacz ocenia kształt, a nie kolejność.
Do tego dochodzą wymagania techniczne. Ten sam rysunek musi zawsze dostać ten sam werdykt. Sprawdzenie ma nic nie kosztować i trwać dużo krócej niż ćwierć sekundy. A wszystko musi działać na naszych zwykłych serwerach API.
Podejście 1: zapytać duży model językowy
Najszybszy prototyp wysyłał każdy rysunek jako obraz do dużego modelu językowego. Pytał, jaki to znak i jak dobrze jest napisany. Na swój sposób działało. Czyste a model rozpoznał z pewnością 0,97, a niechlujne ocenił nisko.
Ale odpowiedź trwała 2,7–4,4 sekundy, a każde kliknięcie kosztowało. Najgorsze było to, że ten sam rysunek za każdym razem dostawał inną ocenę. Uczeń, który dwa razy naciśnie „sprawdź” i dostanie dwa werdykty, przestaje ufać ćwiczeniu. Porzuciliśmy ten pomysł tego samego dnia.
Podejście 2: dopasować wzorce, a decyzję zostawić sędziemu
Druga wersja dopasowywała wzorce. Użyliśmy rozpoznawania chmur punktów $P (Vatavu, Anthony i Wobbrock, 2012). Rysunek zamienia się w chmurę punktów, a algorytm szuka najbliższego zapisanego wzorca. Znaliśmy to już z naszych kursów alfabetu.
Pierwszy prawdziwy test, ręcznie obrysowana tajska ก, dał wynik zero. Testy automatyczne były zbyt łaskawe. Wzorzec, zbudowany z czcionki, rozpadał się na cztery kawałki. Lekko poruszone kopie zepsutego wzorca wciąż idealnie pasują do siebie nawzajem. Testy przechodziły, a prawdziwe rysunki nie.
Przebudowaliśmy więc całość wokół pomiarów zamiast jednej odległości. Dla każdego rysunku liczymy około tuzina liczb: jak blisko jest do celu w porównaniu z najbliższym innym znakiem, ile atramentu brakuje albo jest za dużo, czy jest zbłąkana kreska, ile jest kropek i kresek. Regresja logistyczna, osobna dla każdego pisma, zamienia te liczby w werdykt.
Z tego etapu wynieśliśmy dwie lekcje:
- Progi mają sufit. Zaostrzanie jednego progu odległości zmniejszało liczbę błędów tylko przez odrzucanie dobrych rysunków. Odsetek przyjętych poprawnych liter łacińskich spadł z 81% do 68%.
- Kolejność kresek nie może wpływać na werdykt. Gdy syntetyczni autorzy zaczęli zmieniać kolejność kresek, przyjmowanie poprawnych rysunków koreańskich i chińskich spadło do 40% i 47%. Nasz pomiar kresek wciąż zależał od kolejności. Wersja niezależna od kolejności, która paruje kreski bez względu na ich porządek, przywróciła oba wyniki do około 71%.
Mała sieć do obrazów
Najtańszą dużą poprawę dała mała konwolucyjna sieć neuronowa (CNN). Patrzy na obrazek rysunku 32×32 i podaje, jak prawdopodobny jest każdy znak. Ma około 190 000 parametrów, waży około 270 kB na pismo i działa w zwykłym numpy, więc API nie potrzebuje żadnej biblioteki uczenia maszynowego. Jej pewność stała się dwoma dodatkowymi wejściami sędziego.
Przyjmowanie znaków podobnych spadło z 1–3% prawie do zera. Odsetek przyjętych poprawnych rysunków tajskich wzrósł z 83% do 98%, koreańskich z 75% do 89%.
Od obrazka do drogi pióra
Obrazek gubi informacje. Na telefonie wiemy, gdzie zaczyna się każda kreska, w którą stronę biegnie i gdzie palec się unosi. Rozpoznawanie z takiej drogi nazywa się rozpoznawaniem pisma online, w odróżnieniu od rozpoznawania offline z obrazu.
Pierwsza sieć sekwencyjna czytała 96 punktów wzdłuż drogi przez cztery warstwy konwolucyjne. Ważyła najwyżej 316 kB i działała w około milisekundę. Porównaliśmy ją z siecią obrazową na tych samych danych, pismo po piśmie. Sieć sekwencyjna wygrała w pięciu pismach, a obrazowa na razie została dla cyrylicy i tajskiego.
Problemem był chiński. Przy 1200 znakach, z których wiele różni się jedną kreską, silnik przyjmował w naszych testach tylko 63% poprawnych rysunków. Dobry znak stawiał na pierwszym miejscu tylko w 46% przypadków.
Audyt: nasze liczby kłamały
Zanim sięgnęliśmy po większy model, sprawdziliśmy, jak mierzymy. Znaleźliśmy dwa błędy, przez które wyglądaliśmy lepiej, niż było naprawdę:
- Zbiór walidacyjny przeciekał. Dzieliliśmy rysunki, a nie autorów, więc pismo tej samej osoby trafiało po obu stronach testu.
- „Losowi” prawdziwi autorzy nie byli losowi. To były pierwsze osoby w pliku.
Po naprawie obu błędów liczby najpierw się pogorszyły. Audyt pokazał też, gdzie naprawdę tracimy. Wąskim gardłem był sędzia, a nie sieć. Dopasowano go do rysunków syntetycznych, więc „dobrze, ale niepewnie” czytał jako „źle”. Odrzucał około 40% rysunków, które sieć rozpoznała poprawnie.
Sieć sekwencyjna, która zadziałała
Druga sieć sekwencyjna była punktem zwrotnym. To ona działa dziś.
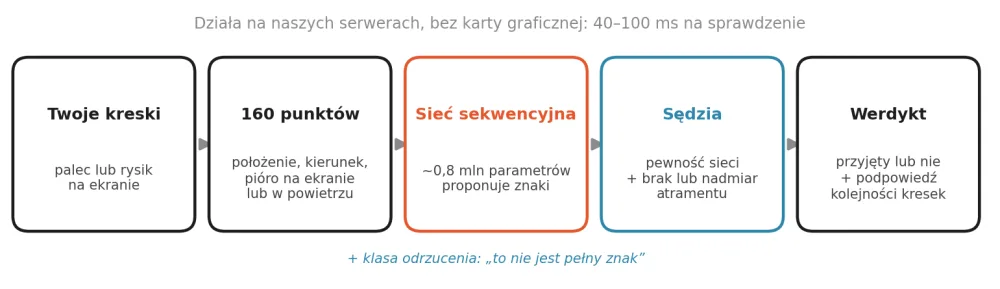
Wejście. Rysunek zamieniamy na 160 punktów. Każdy punkt niesie położenie, ruch pióra, jego orientację (w postaci, która się nie zmienia, gdy kreskę narysowano od końca), skok pióra w powietrzu między kreskami i znacznik uniesienia pióra. Stara sieć skoki w powietrzu wyrzucała.
Sieć. To rezydualna jednowymiarowa CNN o szerokości 128 kanałów. Jej warstwy są rozrzedzone: patrzą na punkty odległe o 1, 2, 4 i 8, i tak dwa razy. Dzięki temu każde wyjście widzi całą drogę. Stara sieć widziała naraz tylko 17 z 96 punktów. Zamiast zwykłego klasyfikatora sieć uczy się dwóch prototypów dla każdego znaku i ocenia rysunek po tym, jak blisko jest każdego z nich.
Trening. Zaburzamy kolejność kresek tak, jak robią to ludzie: czasem zamieniamy sąsiednie kreski, rzadko odwracamy jedną. Losowe zniekształcenia są na początku silne i do końca treningu wygasają do zera, więc sieć kończy na czystych kształtach. Model chiński trenuje się przez 40 epok.
Wdrożenie. Do działania łączymy warstwy normalizacji z konwolucjami i eksportujemy wagi do numpy. Model waży 1,5–2,1 MB na pismo, ma około 0,8 miliona parametrów, a jedno przejście trwa około 5 ms na procesorze.
Dwie zmiany wokół sieci znaczyły tyle samo co sama sieć:
- Sieć proponuje kandydatów. Dopasowywanie wzorców tylko ustawia je w kolejności i wyjaśnia. Samo to podniosło rozpoznanie hangul z 53,4% do 95,5%.
- Sędzia nie może nagradzać bałaganu. Pozostawiona sama sobie regresja nauczyła się, że prawdziwi autorzy zostawiają dużo brakującego i nadmiarowego atramentu. Dała tym cechom dodatnie wagi i odrzucała 42% idealnych rysunków podręcznikowych. Teraz narzucamy znak każdej wagi. Brakujący atrament może tylko obniżyć ocenę.
Dla chińskiego odsetek przyjętych poprawnych rysunków wzrósł z 63,3% do 96,7%, a rozpoznanie z 46,1% do 97,7%. Ale sieć tak dobrze czytała niechlujne pismo, że czytała też rysunki niepełne. Przyjęte wadliwe rysunki wzrosły z 15,6% do 29,5%.
Jak nauczyć sieć mówić „to nie jest znak”
Rozwiązaniem była dodatkowa klasa odrzucenia. Sieć uczy się, jak wygląda zepsuty rysunek, i może odpowiedzieć „żaden z nich”. Dojście do dobrej wersji zajęło pięć podejść.
大 bez jednej kreski to 人. Pierwsza sieć z odrzuceniem zaczęła odrzucać poprawne 人. Oznaczyliśmy „大 bez kreski” jako błąd, a ten rysunek jest znakiem 人.
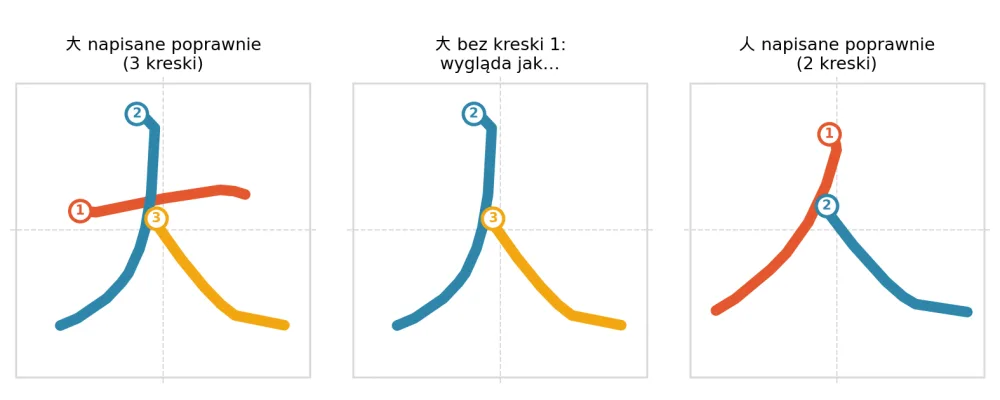
Dlatego filtrujemy błędy. Starsza sieć bez klasy odrzucenia czyta każdy wygenerowany błąd. Jeśli z pewnością co najmniej 50% widzi w nim inny prawdziwy znak, taki błąd wypada. Wypadło około 16%.
Uczniowie piszą jak w podręczniku. Rodzimi dorośli nie. Następna wersja myliła 6% idealnych znaków podręcznikowych. 爸 czytała jako 职 z pewnością 99,9%. Sieć wytrenowana na płynnym, szybkim piśmie dorosłych rzadko widziała staranną formę podręcznikową, a właśnie taką piszą uczniowie. Dodaliśmy po 200 syntetycznych rysunków na znak, z czego 40% prawie podręcznikowych, a potem po 12 dokładnych kopii podręcznikowych na znak.
Ostateczny generator tworzy sześć rodzajów błędów w stałych proporcjach: brakująca kreska (28%), dodatkowa kreska (23%), kreska pożyczona z innego znaku (14%), rysunek ucięty (14%), odbity lustrzanie (7%) i obrócony (7%). Bazgroły doszły później.
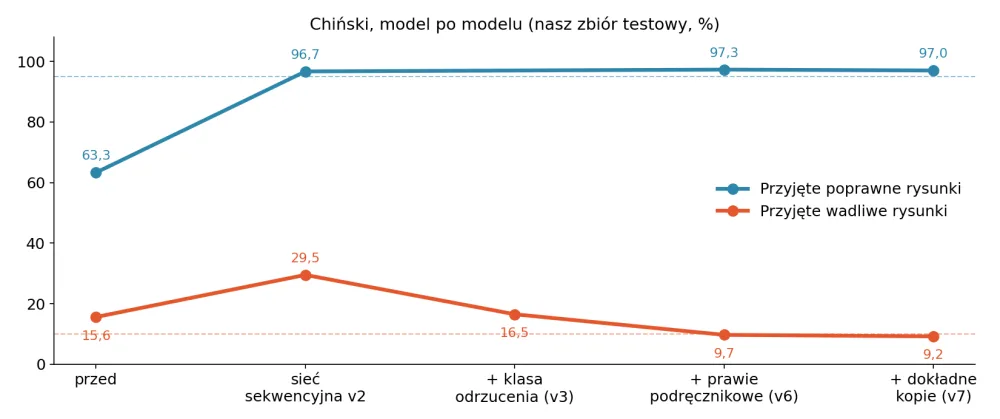
Model chiński, który działa w aplikacji, przyjmuje 97,0% poprawnych rysunków, przepuszcza 9,2% wadliwych i rozpoznaje 97,6% znaków. Przyjmuje też 100% dokładnych rysunków podręcznikowych. 14 października przenieśliśmy na ten sam przepis wszystkie pozostałe pisma.
Skąd dane do trenowania
Wymieniamy tylko dane, które każdy może pobrać:
| Źródło | Co zawiera | Licencja |
|---|---|---|
| UNIPEN | prawdziwe zapisy ruchu pióra, litery łacińskie | CC BY 4.0 |
| UJI Pen Characters | prawdziwe zapisy ruchu pióra, litery łacińskie | CC BY 4.0 |
| Omniglot | rysunki 20 osób na alfabet, w tym grecki i cyrylica | MIT |
| Make Me a Hanzi | dane kresek dla ponad 9000 znaków chińskich | Arphic PL / LGPL |
| Noto i inne otwarte czcionki | kształty liter we wszystkich pismach | SIL OFL |
Dla pisma tajskiego, arabskiego, koreańskiego, greckiego i cyrylicy nie ma darmowego zbioru prawdziwych kresek, wystarczająco dużego do trenowania. Dla tajskiego nie ma żadnego publicznego zbioru zapisów pióra. Zbudowaliśmy więc syntetyczną rękę. Nałożyliśmy wzorcowe kształty na 3285 prawdziwych rysunków z UNIPEN i zmierzyliśmy, jak ludzie zniekształcają litery: typowe pochylenie ±13°, skos, rozciągnięte proporcje i drżenie rzędu 3% wielkości litery. Około 8% autorów łączy kreski, które wzorzec rozdziela. Prawdziwe pismo okazało się dwa do trzech razy bardziej niechlujne, niż zakładaliśmy. Założenie jest takie, że ten sam nadgarstek pisze po tajsku i po łacinie. Jedna dopasowana ręka pisze więc każdy znak w każdym piśmie, tysiące razy.
Czcionki okazały się kiepskimi nauczycielami. Opisują obrysy, a nie ruchy. Gdy zbudowaliśmy dane kresek dla koreańskiego z obrysów czcionek, 36% sylab miało złą liczbę kresek. Odbudowaliśmy je według norm nauczania.
Trening na jednym laptopie
Wszystko trenujemy nocami na układzie graficznym jednego laptopa (M1 Pro z 16 GB pamięci wspólnej z resztą systemu). Dla tej sieci to 19 razy szybciej niż procesor laptopa: 8 minut na milion rysunków zamiast 151. Trening dla chińskiego trwa od dwóch do siedmiu godzin, dla łacińskiego poniżej pół godziny.
Laptop jest też komputerem do pracy, więc trening działa pod okiem strażnika. Strażnik pilnuje pamięci i wstrzymuje albo zapisuje trening, zanim system zacznie korzystać z pliku wymiany. Każdy przebieg treningowy i testowy jest zapisany razem z ustawieniami i wynikami. W pięć dni zebraliśmy ich ponad 150.
Co poszło nie tak:
- Krok budowania danych wisiał siedem godzin. Procesy robocze uruchomiono metodą fork już po starcie biblioteki graficznej i zakleszczyły się. Jedyny alarm, jaki ustawiliśmy, brzmiał „daj znać, gdy się uda”. Teraz każde czekanie ma też limit czasu.
- Zbyt wiele wątków obliczeniowych sprawiło, że generowanie danych trwało 23 minuty zamiast jednej. Każdy proces roboczy dostaje teraz jeden wątek.
- Nasze narzędzie porównawcze oceniało nowy model na pomiarach starego. Trzy werdykty były błędne i trzeba je było powtórzyć.
Jak mierzymy i kiedy model wygrywa
Każde pismo ma opisany korpus testowy z dwóch części, które nigdy nie dzielą autora:
- TUNE to jedyna część, na której podejmujemy decyzje.
- HOLDOUT służy tylko do raportowania. Gdybyśmy na nim stroili, przestałby mówić prawdę.
Każda część zawiera poprawne rysunki od starannych po niechlujne, znaki podobne (dobry rysunek innego znaku), błędy i bazgroły. Mierzymy:
| Miara | Co znaczy | Cel |
|---|---|---|
| Przyjęte dobre | poprawne rysunki, od starannych po dość niechlujne, które przechodzą | ≥ 95% |
| Przyjęte podobne | inny znak przyjęty jako docelowy | ≤ 0,5% |
| Przyjęte wadliwe | niepełny albo zepsuty rysunek, który przechodzi | ≤ 10% |
| Rozpoznanie | dobry znak jest pierwszym typem | ≥ 85% (chiński ≥ 97%) |
| Podręcznik | dokładny rysunek podręcznikowy przechodzi | ≥ 99% |
| Szybkość | 95% sprawdzeń z odpowiedzią w ciągu | 250 ms |
Te miary składają się w jedną ocenę na TUNE. Nagradza przyjęte poprawne rysunki, dodaje mniejszą nagrodę za niechlujne i odejmuje ostre kary powyżej 2% znaków podobnych i 10% błędów. Kandydat zastępuje działający model tylko wtedy, gdy pobije tę ocenę o więcej niż 0,01 i na HOLDOUT zostanie na poziomie najwyżej 0,5% znaków podobnych. W przeciwnym razie stary model, jego kalibracja i ustawienia wracają co do bajtu.
Ta zasada nieraz kosztowała nas ładniejsze liczby. Większa sieć dla pisma łacińskiego, greckiego i cyrylicy (192 kanały, 60 epok) obniżyła błędy na HOLDOUT do 8–9%, ale przegrała na TUNE. Zostawiliśmy mniejszą. Rozmiar sieci nie był granicą.
Wyniki dla każdego pisma
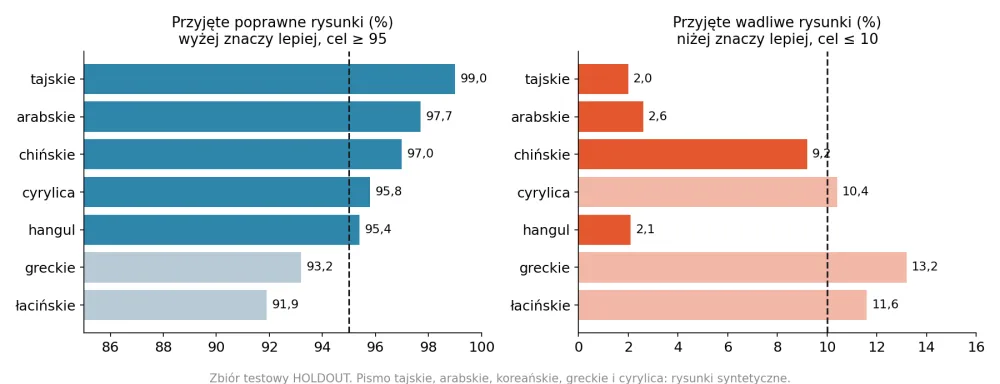
Wyniki na HOLDOUT:
| Pismo | Znaki | Przyjęte dobre | Przyjęte podobne | Przyjęte wadliwe | Rozpoznanie |
|---|---|---|---|---|---|
| tajskie | 74 | 99,0% | 0,1% | 2,0% | 99,3% |
| arabskie | 100 form | 97,7% | 0% | 2,6% | 97,8% |
| chińskie | 1200 | 97,0% | 0% | 9,2% | 97,6% |
| cyrylica | 66 | 95,8% | 0% | 10,4% | 98,2% |
| hangul | 924 sylaby | 95,4% | 0,1% | 2,1% | 95,5% |
| greckie | 48 | 93,2% | 0,4% | 13,2% | 94,1% |
| łacińskie | 62 | 91,9% | 0% | 11,6% | 90,4% |
Dla pisma tajskiego, arabskiego, koreańskiego, greckiego i cyrylicy rysunki testowe pochodzą z syntetycznej ręki i z garstki rysunków wykonanych ręcznie. Te wiersze czytaj jako „jak dobrze sprawdzacz radzi sobie z rękami, które umiemy zasymulować”.
Szybkość okazała się problemem wątków, a nie modelu. Na obciążonej maszynie domyślna biblioteka obliczeń numpy uruchamiała pełną pulę wątków przy każdym małym mnożeniu macierzy i wątki walczyły o rdzenie. Z jednym wątkiem na proces mediana sprawdzenia spadła z 280–450 ms do 42 ms dla łacińskiego, 60 ms dla greckiego i 101 ms dla chińskiego. W obrazie produkcyjnym 95. percentyl dla łacińskiego spadł z 76 ms do 26 ms.
Czego jeszcze nie umie
- Pismo tajskie nie spotkało jeszcze prawdziwych tajskich rąk. Wszystkie jego liczby są syntetyczne. Sieć obrazowa, którą zastąpiło, uczyła się na zeskanowanym tajskim piśmie, ale w naszych testach wygrywa sieć sekwencyjna i to ona działa. Więcej powiedzą nam rysunki uczniów.
- Pismo łacińskie, greckie i cyrylica są poniżej celu. Najtrudniejsza jest krótka dodatkowa kreska przecinająca literę. Żaden pomiar nie odróżnia jej od płynnego połączenia. Nasze zbiory TUNE są małe, więc o porównaniach decydują pojedyncze przypadki. Następny krok to większy korpus TUNE.
- Chiński wciąż przepuszcza część rysunków bez jednej kreski.
- Nie mamy jeszcze prawdziwych rysunków uczniów. Za zgodą uczniów staną się najważniejszym zbiorem testowym.
- Japońskiego jeszcze nie obsługujemy. Pracujemy nad tym. Kana to naturalny następny krok, a kanji dzielą większość kresek z chińskim.
Jak sprawdzamy, czy narzędzie pomiarowe mówi prawdę, opisaliśmy w artykule o testowaniu lektorów AI. O ocenie mowy zamiast pisma przeczytasz w tekście jak AI ocenia wymowę.
Najczęściej zadawane pytania
Czy rozpoznawanie pisma działa na telefonie?
Nie. Telefon wysyła kreski, a nasze serwery sprawdzają je w zwykłym numpy, bez karty graficznej. Sprawdzenie trwa 40–100 ms, więc wydaje się natychmiastowe.
Dlaczego nie użyliście ChatGPT albo innego modelu AI?
Próbowaliśmy. Duży model językowy potrzebował do 4,4 sekundy na rysunek, każde sprawdzenie kosztowało, a ten sam rysunek dostawał różne oceny. Mała wyspecjalizowana sieć jest szybsza, nic nie kosztuje przy sprawdzeniu i zawsze daje tę samą odpowiedź.
Czy sprawdza kolejność kresek?
Widzi kolejność i kierunek każdej kreski i używa ich do podpowiedzi. Nigdy nie odrzuca rysunku za kolejność. Badania nie pokazują, że jedna konkretna kolejność pomaga w nauce, a gdy kolejność się liczyła, poprawne rysunki innych osób były odrzucane zdecydowanie za często.
Na jakich danych go trenowaliście?
Na prawdziwych zapisach liter łacińskich (UNIPEN, UJI Pen Characters), rysunkach z Omniglot, danych kresek z Make Me a Hanzi i otwartych czcionkach. Dla większości pism rysunki treningowe pochodzą z syntetycznej ręki dopasowanej do prawdziwego pisma.
Jak trafne jest to rozpoznawanie pisma?
W naszych testach HOLDOUT przyjmuje 95–99% poprawnych rysunków w piśmie tajskim, arabskim, chińskim, cyrylicy i hangul oraz 92–93% w łacińskim i greckim. Prawie nigdy nie przyjmuje znaku podobnego (najwyżej 0,4%).