Synteza mowy pod lupą: jak mierzymy 12 lektorów AI

Synteza mowy potrafi brzmieć naturalnie i mimo to powiedzieć nie to słowo. Zmierzyliśmy 12 głosów od czterech dostawców na parach minimalnych, czyli słowach różniących się jedną głoską. Najlepsze głosy angielskie przeniosły 92–97% różnic, najlepsze norweskie około 80%. Najsłabszy u każdego głosu był ton. Poniżej pokazujemy, jak to mierzymy, razem ze spektrogramami.
Spis treści
- Po co w ogóle testujemy lektorów AI
- Co mierzymy i dlaczego akurat to
- Spektrogram w minutę
- Formanty samogłosek: jak mierzymy barwę
- Długość samogłoski: liczy się kierunek
- Dźwięczność: czas rozpoczęcia dźwięczności (VOT)
- Intonacja i toneme: częstotliwość podstawowa
- Czy AI potrafi ocenić wymowę? wav2vec2, Whisper i audio-LLM-y
- Jak sprawdziliśmy, że test jest uczciwy
- Wyniki: który lektor AI wymawia poprawnie?
- Co z tym robimy
- Ograniczenia
- Najczęściej zadawane pytania
Po co w ogóle testujemy lektorów AI
Każda karta w Taalhammerze ma nagranie. Tworzy je synteza mowy, czyli lektor AI, w 76 językach. Uczeń powtarza to, co słyszy. Jeśli nagranie rozmywa różnicę między dwoma słowami, nie ma się z czego uczyć. Uczeń wyćwiczy wtedy właśnie ten błąd.
Rankingi syntezy mowy tu nie pomagają. Zestawienia takie jak Artificial Analysis oceniają, jak naturalnie brzmi głos, jak szybko działa i ile kosztuje. Żadne nie sprawdza, czy głos odróżnia dźwięki zmieniające znaczenie słowa. A w nauce języka to jest najważniejsze.
Co mierzymy i dlaczego akurat to
Para minimalna to dwa słowa różniące się jednym dźwiękiem. Po norwesku tak to „dach", a takk to „dziękuję". Więcej o nauce na takich parach piszemy w tekście o wymowie norweskiej dla Polaków.
Mierzymy tylko różnice, które zmieniają znaczenie, a których dorosłe ucho łatwo nie słyszy. Nie oceniamy, czy głos jest ładny albo emocjonalny. Sprawdzamy osiem rodzajów kontrastów:
| Kontrast | Przykład | Co mierzymy | Zaliczone, gdy |
|---|---|---|---|
| Długość samogłoski | tak – takk | czas trwania samogłoski | długa ≥ 1,25 × krótka |
| Barwa samogłoski | lys – lus | formanty samogłosek F1–F3 | różnica ≥ 0,8 Barka |
| Dyftongi | vei – vi | ruch formantów | różnica ≥ 0,8 Barka |
| Dźwięczność | ben – pen | czas rozpoczęcia dźwięczności (VOT) | różnica ≥ 20 ms |
| Szczelinowe | kjekk – sjekk | środek ciężkości szumu | różnica ≥ 500 Hz |
| [h] | hår – år | szum przed samogłoską | ≥ 8 dB głośniej |
| Retrofleksy | kart – katt | F3 na końcu samogłoski | ≥ 150 Hz niżej |
| Toneme | bønder – bønner | przebieg wysokości dźwięku | spadek większy o ≥ 1,2 półtonu |
Badaliśmy 44 pary norweskie i 37 angielskich. Wybraliśmy je według częstości słów, a nie według tego, jak radził sobie któryś głos. Każde słowo syntetyzowaliśmy osobno, tak jak woła się API dostawcy. Razem dało to 1788 nagrań.
Spektrogram w minutę
Spektrogram pokazuje dźwięk jako obraz. Czas biegnie od lewej do prawej, częstotliwość od dołu do góry, a im ciemniej, tym głośniej. Samogłoski to ciemne, prążkowane bloki. Spółgłoska zwarta, jak k, to pusta przerwa i krótki wybuch szumu. To wystarczy, żeby zobaczyć pierwszy kontrast.
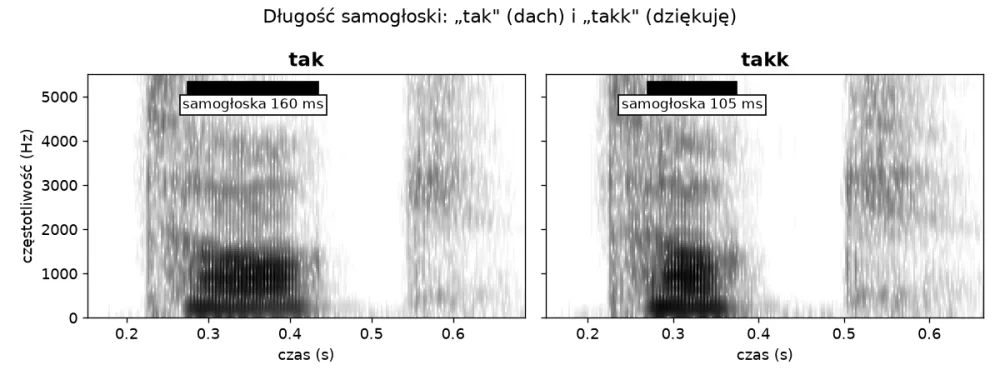
W tak samogłoska trwa 160 ms, w takk 105 ms. Stosunek 1,52 wyraźnie przekracza nasz próg 1,25. Wszystkie rysunki pochodzą z Praata, standardowego programu fonetycznego, którym sterujemy z Pythona przez Parselmouth.
Formanty samogłosek: jak mierzymy barwę
Uwaga na słowo: w szkolnej gramatyce „formant" to cząstka słowotwórcza. Tutaj chodzi o coś innego, o fonetykę akustyczną. Jama ustna to rura, która rezonuje na pewnych częstotliwościach. Te rezonanse to właśnie formanty samogłosek i to one odróżniają jedną samogłoskę od drugiej. W uproszczeniu F1 mówi, jak szeroko otwarte są usta. F2 mówi, jak bardzo z przodu jest język. F3 reaguje na zaokrąglenie warg i na r.
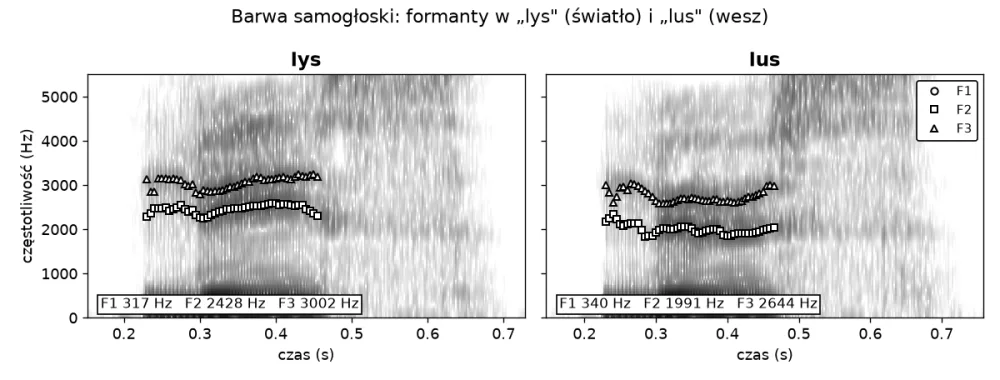
Norweskie y w lys („światło") i u w lus („wesz") to wysokie samogłoski z zaokrąglonymi ustami. Różnica siedzi w F2: około 2430 Hz wobec 1990 Hz, bo przy u język jest cofnięty. Mierzymy to tak:
- znajdujemy samogłoskę (głośna, dźwięczna, energia nisko w widmie);
- liczymy formanty metodą predykcji liniowej (Burga) przy kilku ustawieniach i bierzemy najstabilniejsze, bo jedno ustawienie zawodzi przy niektórych głosach;
- bierzemy medianę ze środka samogłoski, gdzie jest najbardziej stabilna;
- przeliczamy na skalę Barka, która oddaje sposób, w jaki ucho słyszy częstotliwość.
Dwie samogłoski uznajemy za różne, gdy dzieli je co najmniej 0,8 Barka. Dyftongi mierzymy podobnie, tylko porównujemy początek i koniec ruchu formantów.
Długość samogłoski: liczy się kierunek
Długość wydaje się prosta: zmierz dwie samogłoski i porównaj. Są jednak dwie pułapki. Granice samogłoski trzeba znaleźć w samym dźwięku, a nie zgadywać z pisowni. Dlatego najpierw lokalizujemy litery modelem rozpoznawania mowy, a potem bierzemy głośny, dźwięczny fragment wokół nich. Po drugie różnica musi iść we właściwą stronę. Wczesna wersja naszego narzędzia przepuściła głos, który wydłużył samogłoskę krótką.
Dźwięczność: czas rozpoczęcia dźwięczności (VOT)
Przy spółgłoskach takich jak p i b liczy się czas. VOT to odstęp między otwarciem warg a początkiem drgań wiązadeł głosowych.
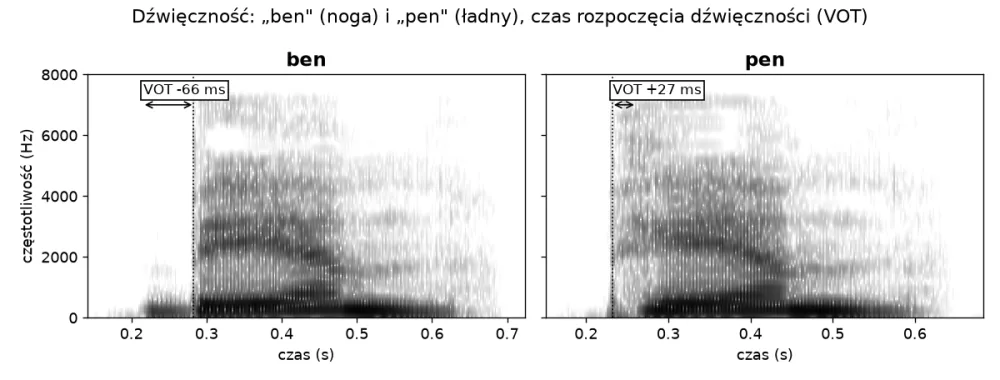
W ben („noga") wiązadła zaczynają drgać 66 ms przed otwarciem warg. To ciemny pasek nisko po lewej stronie. W pen („ładny") zaczynają 27 ms po nim. Dlatego mierzymy VOT ze znakiem: liczba bez znaku nie zobaczy wcześniejszego udźwięcznienia. Dla kj i sj porównujemy „barwę" szumu, czyli jego środek ciężkości w widmie. Dla h szukamy szumu przed samogłoską.
Intonacja i toneme: częstotliwość podstawowa
Norweski ma dwa toneme. Słowa bønder („rolnicy") i bønner („fasola") mają te same samogłoski i spółgłoski. Różni je tylko melodia.
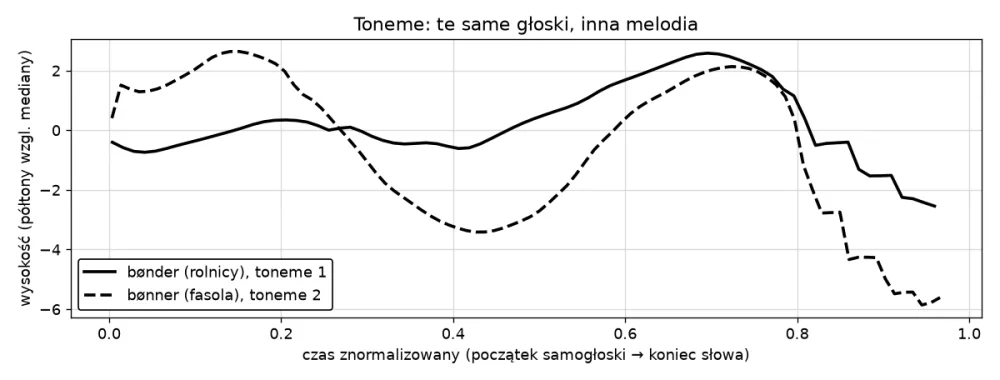
Melodia to częstotliwość podstawowa (F0), czyli tempo drgań wiązadeł głosowych. Śledzenie wysokości dźwięku szacuje ją dla każdej krótkiej ramki. Każdy algorytm czasem się myli, na przykład skacze o oktawę. Dlatego używamy dwóch niezależnych: autokorelacji filtrowanej z Praata i pYIN. Wynik przeliczamy na półtony i mierzymy, jak głęboko spada melodia po pierwszym szczycie. Na rysunku bønner (toneme 2) spada o około sześć półtonów i znowu rośnie. Bønder pozostaje prawie płaskie. Kontrast zaliczamy, gdy toneme 2 spada o co najmniej 1,2 półtonu głębiej.
Ton to największa słabość syntezy mowy. To melodia całego słowa, a w naszych testach był najsłabszym kontrastem u każdego głosu.
Czy AI potrafi ocenić wymowę? wav2vec2, Whisper i audio-LLM-y
Samą akustykę da się czasem oszukać. Dlatego każdy werdykt potrzebuje drugiej opinii od modelu mowy.
- wav2vec2 (model norweskiej Biblioteki Narodowej; dla angielskiego model angielski) rozpoznaje litery w nagraniu. Pytamy go o wybór: czy nagranie takk pasuje bardziej do pisowni takk czy tak? Jeśli woli drugie słowo, para odpada, nawet przy dobrej akustyce.
- Druga kontrola porównuje wewnętrzne reprezentacje obu nagrań. Jeśli są prawie identyczne, głos powiedział dwa razy to samo.
Para przechodzi tylko wtedy, gdy akustyka i model się zgadzają. Gdy się nie zgadzają, wynik jest „niepewny" i nie liczy się jako zaliczony.
Sprawdziliśmy też, czy nowsze AI może to zastąpić. Trzy modele audio OpenAI (gpt-audio, gpt-audio-1.5, gpt-audio-mini) słyszały jedno słowo i miały wybrać jedno z dwóch. Oba słowa pary trafiły tylko w 2–8 z 20 par, a zgadywanie daje 5. W parach tonemowych trafiły 0–1 z 4. Otwarte modele rozpoznawania mowy poradziły sobie lepiej:
| Model | Rozpoznane pary (z 20) | Pary tonemowe (z 4) |
|---|---|---|
| nb-whisper-medium (norweski Whisper) | 17 | 3 |
| wav2vec2, norweski | 15 | 1 |
| whisper-large-v3-turbo | 9 | 0 |
| OWSM v3.1 | 5 | 0 |
| modele gpt-audio | 2–8 | 0–1 |
Norweski Whisper jako jedyny słyszał ton. Żeby mieć pewność, że słucha melodii, przenieśliśmy przebieg wysokości jednego słowa na nagranie drugiego. Jego odpowiedź poszła za melodią w 5 przypadkach na 6.
Jak sprawdziliśmy, że test jest uczciwy
Pomiar, który zawsze mówi „różne", jest bezużyteczny. Dlatego najpierw przetestowaliśmy samo narzędzie:
- Na 27 kontrastach potwierdzonych wcześniej na spektrogramach zaliczyło 25 (93%). Pozostałe dwa wyszły jako „niepewne", nigdy jako fałszywe zaliczenie.
- Na 29 nagraniach bez prawdziwej różnicy fałszywie zaliczyło jedno (3%). Były to na przykład to samo słowo lekko przetworzone, zamieniona melodia albo wycięte h.
- Dla każdego głosu i każdej pary dodaliśmy kontrolę: słowo kontra przetworzona wersja samego siebie. Fałszywe zaliczenia wyniosły 0–5% dla wszystkich 24 głosów. Narzędzie nie faworyzuje dostawcy.
Przy około 40 parach na głos każdy wynik ma margines mniej więcej ±12 punktów. Mniejsze różnice to szum.
Wyniki: który lektor AI wymawia poprawnie?
Procent par minimalnych, w których różnica jest mierzalnie obecna:
| Głos | Norweski (44 pary) |
|---|---|
| Azure Iselin | 80% |
| Azure Finn | 77% |
| Azure Pernille | 77% |
| Google Chirp 3 HD Kore | 77% |
| Google Chirp 3 HD Charon | 68% |
| ElevenLabs v3 George | 68% |
| OpenAI coral | 68% |
| Google Chirp 3 HD Aoede | 66% |
| Google Chirp 3 HD Puck | 66% |
| Google Chirp 3 HD Leda | 64% |
| OpenAI ash | 64% |
| ElevenLabs v3 Lily | 59% |
| Głos | Angielski (37 par) |
|---|---|
| Google Chirp 3 HD Puck | 97% |
| ElevenLabs v2 George | 95% |
| Azure Sonia (GB), Chirp Aoede, ElevenLabs Lily, OpenAI coral, OpenAI ash | 92% |
| Google Chirp 3 HD Leda | 89% |
| Azure Jenny, Chirp Charon | 86% |
| Google Chirp 3 HD Kore | 84% |
| Azure Andrew | 73% |
Co się wyróżnia:
- Każdy głos lepiej radzi sobie z angielskim niż z norweskim. Średnie dostawców dla norweskiego: Azure 78%, Chirp 68%, OpenAI 66%, ElevenLabs 64%. Dla angielskiego: ElevenLabs 94%, OpenAI 92%, Chirp 90%, Azure 84%.
- Najlepsze głosy norweskie remisują w granicach błędu. Prawdziwa przewaga Azure to zrozumiałość: 94% jego słów model rozpoznał jako te same słowa, wobec 84% u Chirpa.
- Toneme przeniosły tylko 17–67% par tonemowych. To najsłabszy kontrast u każdego głosu.
- Azure Andrew wydłuża samogłoskę przed dźwięczną spółgłoską, ale samą spółgłoskę ubezdźwięcznia. Jego ridge słychać jako rich. Polakom ten błąd jest dobrze znany z angielskiego.
- Niektóre głosy nie są deterministyczne. Chirp na to samo zapytanie dał nam różne nagrania: raz samogłoska w tak trwała 5 ms, a raz 260 ms. Zapisany plik trzeba więc zmierzyć. Podanie Chirpowi dokładnej wymowy w IPA też nie pomogło.
Co z tym robimy
Żaden głos nie przenosi wszystkich kontrastów. Różnice między rodzajami kontrastów są większe niż różnice między dostawcami. Dlatego nie wybieramy jednego „najlepszego lektora AI". Dla każdej karty z parą minimalną próbujemy kolejnych głosów, aż pomiar potwierdzi, że któryś przenosi różnicę. Ten głos przypinamy do karty. Potem sprawdzamy, czy aplikacja odtwarza dokładnie zmierzony plik.
Ten test przeszło każde nagranie w tekście o wymowie norweskiej dla Polaków. Jeśli zapis IPA jest dla ciebie nowy, zajrzyj do naszego przewodnika po alfabecie fonetycznym. Inne spojrzenie pod maskę znajdziesz w tekście o tym, jak budujemy algorytm n+1.
Ograniczenia
Testowaliśmy tylko głosy syntetyczne, jeden standard norweskiego (Oslo) i kilka par na kontrast. Pojedyncze komórki tabel są więc obarczone szumem. W tej rundzie nie testowaliśmy modeli Gemini od Google. Progi fonetyczne skalibrowaliśmy na własnych potwierdzonych przykładach, a nie na opublikowanym benchmarku.
Najczęściej zadawane pytania
Czy synteza mowy wystarczy do nauki wymowy?
W angielskim w dużej mierze tak: najlepsze głosy przeniosły 92–97% badanych kontrastów. W norweskim to bliżej 80%, więc warto korzystać ze sprawdzonych nagrań i słuchać kilku głosów.
Który lektor AI najlepiej wymawia po norwesku?
W naszym teście najwyżej wypadł Azure Iselin (80%). Tuż za nim są Azure Finn, Azure Pernille i Google Chirp 3 HD Kore (77%). Różnica między nimi mieści się w granicach błędu.
Dlaczego synteza mowy ma problem z norweskimi tonemami?
Toneme to melodia całego słowa, a nie pojedyncza głoska. Pisownia zwykle go nie zaznacza. Każdy badany głos przeniósł go najwyżej w 67% par tonemowych.
Jak sprawdzić, czy lektor AI poprawnie wymawia słowo?
Porównujemy je z drugim słowem pary minimalnej. Mierzymy cechę, która je odróżnia (długość, formanty, VOT albo wysokość dźwięku), i sprawdzamy, czy model rozpoznawania mowy też słyszy właściwe słowo.
Czy ChatGPT albo inne audio-AI ocenią, czy wymowa jest poprawna?
Jeszcze nie w wiarygodny sposób. Modele audio OpenAI rozpoznawały norweskie pary minimalne na poziomie bliskim zgadywania. Norweski Whisper poradził sobie dużo lepiej i jako jedyny słyszał ton.