Algorytm FSRS: jak działa i czym różni się od SM-2
FSRS (Free Spaced Repetition Scheduler) to otwarty algorytm, który decyduje, kiedy masz znowu zobaczyć fiszkę. Dla każdej karty pamięta trzy liczby, przewiduje, z jakim prawdopodobieństwem ją jeszcze pamiętasz, i wyznacza powtórkę na dzień, w którym to prawdopodobieństwo spadnie do wybranego przez ciebie progu. Jego 21 parametrów dopasowuje się do prawdziwej historii powtórek metodami uczenia maszynowego. Anki ma FSRS od wersji 23.10. W 2026 roku wytrenowaliśmy go na powtórkach naszych uczniów i porównaliśmy z algorytmem SM-2, którego używamy od 2019 roku. Ten tekst wyjaśnia, jak FSRS działa, jak się go trenuje i co pokazały nasze dane.
Spis treści
- Po co w ogóle algorytm powtórek
- SM-2 w minutę
- Model pamięci: trudność, stabilność, przypominalność
- Od pamięci do daty: docelowa retencja
- Co się dzieje po każdej powtórce
- 21 parametrów
- Jak FSRS się uczy
- Czy to działa: jak czytać benchmark
- Jak wytrenowaliśmy FSRS na danych naszych uczniów
- Nauka języka jest inna
- Co dalej: FSRS-7
- Najczęściej zadawane pytania
- Gdzie czytać dalej
Po co w ogóle algorytm powtórek
Powtórzysz kartę za wcześnie, a stracisz czas na coś, co i tak pamiętasz. Powtórzysz za późno, a zaczynasz od nowa. Najlepszy moment leży pośrodku i przesuwa się: im lepiej coś znasz, tym dłużej możesz czekać.
To efekt rozłożenia nauki w czasie, jeden z najlepiej potwierdzonych wyników badań nad pamięcią. Metaanaliza 317 eksperymentów pokazała, że nauka rozłożona w czasie wygrywa z wkuwaniem, a najlepsza przerwa rośnie razem z tym, jak długo masz coś pamiętać (Cepeda i in., 2006). W kolejnym badaniu, na ponad 1350 osobach, przy teście za tydzień najlepsza przerwa wynosiła 20–40% tego tygodnia, a przy teście za rok 5–10% roku (Cepeda i in., 2008). Algorytm powtórek szuka tego momentu dla każdej karty i każdego ucznia osobno. Historię tego odkrycia opisujemy w tekście o krzywej zapominania.
SM-2 w minutę
Na algorytmie SM-2 wyrosła większość aplikacji z fiszkami. Opublikował go Piotr Woźniak dla programu SuperMemo w grudniu 1987 roku (SuperMemo). To polski wynalazek:
q to ocena od 0 do 5; poniżej 3 karta zaczyna od I(1). Odstępy w dniach.
Każda karta ma współczynnik łatwości (EF). Każda powtórka mnoży przez niego odstęp, a twoja ocena lekko go podnosi albo obniża. Prosto i skutecznie, dlatego przetrwało 35 lat.
Słaby punkt jest jeden. SM-2 nie mówi, jak bardzo prawdopodobne jest, że kartę pamiętasz. Mówi tylko, kiedy ją pokazać. Bez prawdopodobieństwa nie da się sprawdzić, czy harmonogram jest dobry, nie da się go ustawić na konkretny cel i nie da się wyliczyć jego liczb z danych. Wartości 2,5, 1,3 i drugi krok 6 dni są takie same dla wszystkich.
Nasz własny algorytm należy do rodziny SM-2 i ma dwie opisane zmiany. Współczynnik łatwości trzymamy między 1,3 a 2,5 i zmieniamy go także po błędnej odpowiedzi, bo tryb słuchania używa go, żeby najtrudniejsze zdania puszczać jako pierwsze.
Model pamięci: trudność, stabilność, przypominalność
FSRS opisuje każdą kartę trzema liczbami. Ten pomysł pochodzi z późniejszych algorytmów SuperMemo i z modelu DHP chińskiej aplikacji MaiMemo (wiki FSRS):
- Przypominalność (R): prawdopodobieństwo, że teraz przypomnisz sobie kartę.
- Stabilność (S): liczba dni, po której R spada ze 100% do 90%. Karta o S = 10 dni z prawdopodobieństwem 90% zostanie zapamiętana 10 dni po powtórce.
- Trudność (D): jak trudna jest karta dla ciebie, od 1 do 10. Od niej zależy, jak szybko rośnie stabilność.
Między powtórkami R spada po krzywej zapominania. W FSRS-6 to krzywa potęgowa, a jej kształt jest jednym z trenowanych parametrów, w20:
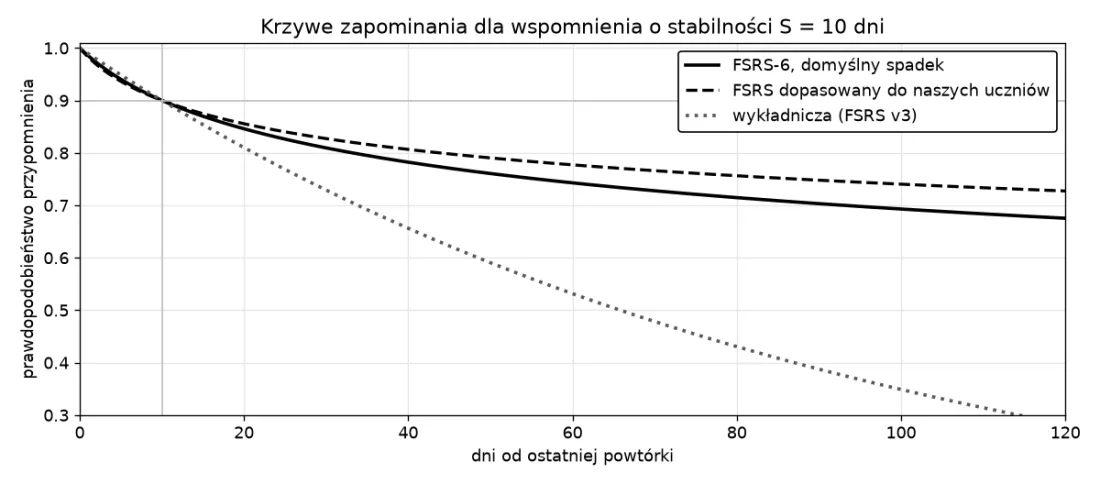
Dlaczego krzywa potęgowa, a nie wykładnicza z podręczników? Bo historia karty miesza wspomnienia o różnej sile. Jeśli uśrednisz krzywe wykładnicze o różnych prędkościach, wyjdzie krzywa, która najpierw spada szybko, a potem się wypłaszcza. Tak właśnie wyglądają dane. U naszych uczniów dopasowana krzywa jest jeszcze płaska (w20 = 0,102 zamiast domyślnych 0,154). Po pierwszych tygodniach nasi uczniowie zapominają wolniej niż przeciętny użytkownik Anki.
Od pamięci do daty: docelowa retencja
FSRS zadaje ci jedno pytanie: z jakim prawdopodobieństwem chcesz pamiętać kartę w dniu powtórki? To docelowa retencja. Wystarczy odwrócić krzywą, żeby dostać odstęp:
Dla karty o S = 10 dni i domyślnej krzywej wybór ma duże znaczenie (liczby wyliczone ze wzoru wyżej):
| Docelowa retencja | Następna powtórka za |
|---|---|
| 80% | 33 dni |
| 85% | 19 dni |
| 90% | 10 dni |
| 95% | 4 dni |
| 97% | około 2 dni |
Prośba o 95% zamiast 90% ponad dwukrotnie zwiększa liczbę powtórek tej karty. Instrukcja Anki ostrzega, że powyżej 90% obciążenie rośnie bardzo szybko (instrukcja Anki). Od wersji 25.07 Anki zamiast kalkulatora minimalnej zalecanej retencji ma symulator obciążenia.
Co się dzieje po każdej powtórce
Po każdej powtórce FSRS aktualizuje trudność i stabilność. Po udanej powtórce stabilność rośnie tym bardziej, im łatwiejsza karta, tym mniej, im bardziej już stabilna, i tym bardziej, im bliżej zapomnienia byłeś. Ten ostatni efekt to rozłożenie w czasie zapisane we wzorze.
Po udanej powtórce (Trudno, Dobrze, Łatwo):
gdzie h = w15 przy „Trudno" (inaczej 1), a b = w16 przy „Łatwo" (inaczej 1).
Po zapomnieniu (Nie pamiętam):
Trudność, dla oceny G od 1 (Nie pamiętam) do 4 (Łatwo):
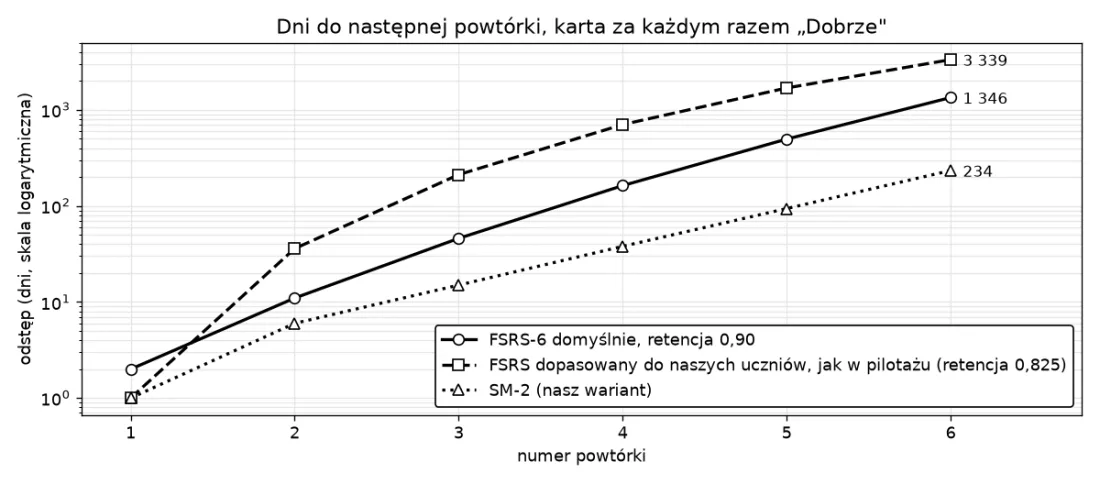
Przykład liczbowy: domyślne parametry FSRS-6, retencja 90%, karta za każdym razem oceniona „Dobrze". Wyliczone pakietem py-fsrs 6.3.1:
| Powtórka | Stabilność po niej | Następna za | SM-2 (nasz wariant) |
|---|---|---|---|
| 1 | 2,3 dnia | 2 dni | 1 dzień |
| 2 | 11,0 dni | 11 dni | 6 dni |
| 3 | 46,3 dnia | 46 dni | 15 dni |
| 4 | 162,9 dnia | 163 dni | 38 dni |
| 5 | 497 dni | 497 dni | 94 dni |
A teraz zapomnij raz. Dwa razy „Dobrze", potem „Nie pamiętam" w 11. dniu: stabilność spada z 11 dni do 1,5, trudność skacze z 2,1 do 7,4, a karta wspina się z powrotem wolniej (2, 5, 12, 28 dni). SM-2 cofnąłby odstęp do jednego dnia i nie wiedziałby, ile wspomnienia przetrwało.
Szczegół, którego oficjalny opis nie podaje: w kodzie referencyjnym stabilność po zapomnieniu jest ograniczona odrobinę poniżej stabilności sprzed zapomnienia, a powtórka tego samego dnia nigdy nie obniża stabilności, jeśli odpowiedziałeś „Trudno" albo lepiej (fsrs-rs).
21 parametrów
FSRS-6 ma 21 wag, od w0 do w20. Nie musisz ich znać, żeby korzystać z algorytmu, ale to cały model (wiki FSRS, granice w fsrs-rs):
| Wagi | Domyślnie | Za co odpowiadają |
|---|---|---|
| w0–w3 | 0,212; 1,293; 2,307; 8,296 | Stabilność w dniach po pierwszej odpowiedzi: Nie pamiętam, Trudno, Dobrze, Łatwo |
| w4, w5 | 6,413; 0,833 | Trudność startowa i jak szybko spada przy lepszej pierwszej odpowiedzi |
| w6, w7 | 3,019; 0,001 | Jak mocno każda odpowiedź zmienia trudność i jak mocno ją ściąga z powrotem |
| w8–w10 | 1,872; 0,167; 0,796 | Wzrost stabilności po sukcesie: skala, hamowanie dla stabilnych kart, premia za powtórkę blisko zapomnienia |
| w11–w14 | 1,484; 0,061; 0,263; 1,648 | Stabilność po zapomnieniu |
| w15, w16 | 0,601; 1,873 | Kara za „Trudno", premia za „Łatwo" |
| w17–w19 | 0,543; 0,091; 0,066 | Powtórki tego samego dnia |
| w20 | 0,154 | Kształt krzywej zapominania |
Jak FSRS się uczy
FSRS to mały model, 21 liczb, i te liczby wylicza się z danych. Tak to wygląda krok po kroku.
Dane to historia powtórek: jaka karta, kiedy i który przycisk nacisnąłeś. Treść karty nie ma tu znaczenia.
Przewidywanie. Model przechodzi przez historię każdej karty po kolei. Przed każdą powtórką liczy R, czyli prawdopodobieństwo, że po tylu dniach kartę pamiętasz. Potem sprawdza, co zrobiłeś naprawdę.
Strata to strata logarytmiczna (entropia krzyżowa). Pewna siebie, błędna prognoza kosztuje dużo, ostrożna mało. Trening szuka takich 21 liczb, przy których cała historia jest jak najmniej zaskakująca.
Optymalizacja to spadek gradientu. Każda prognoza zależy od poprzednich powtórek karty, więc błąd cofa się przez całą sekwencję, tak jak przy trenowaniu rekurencyjnej sieci neuronowej. W implementacji Anki to optymalizator Adam z krokiem uczenia 0,04, pięć przejść przez dane, porcje po 512 powtórek, kara za zbyt duże odejście od wartości domyślnych i przycinanie każdej wagi do dozwolonego zakresu po każdym kroku (trening w fsrs-rs). Cztery stabilności startowe szacuje się wcześniej, z tego, jak często pamiętane były pierwsze odpowiedzi.
Ile danych potrzeba? Instrukcja Anki mówi o co najmniej „kilkuset" powtórkach i o tym, że ponowny trening raz w miesiącu wystarczy. Same parametry domyślne dopasowano na kilkuset milionach powtórek około 10 tysięcy użytkowników Anki (wiki FSRS).
To uczenie maszynowe w zwykłym sensie: parametry wyliczone z danych przez minimalizację straty. Ale nie czarna skrzynka. Możesz wypisać te 21 liczb i sprawdzić, co każda robi.
Czy to działa: jak czytać benchmark
Otwarty srs-benchmark sprawdza algorytmy na 9999 kolekcjach Anki, około 350 milionach powtórek. Każdy model uczy się na starszych powtórkach, a sprawdza na nowszych. Liczą się trzy miary:
- Strata logarytmiczna: jak dobre są prawdopodobieństwa. Im mniej, tym lepiej.
- RMSE (bins): jak daleko przewidziana pamięć jest od prawdziwej, w grupach podobnych powtórek. Im mniej, tym lepiej.
- AUC: jak dobrze model odróżnia karty, które zapomnisz, od tych, które zapamiętasz. 0,5 to rzut monetą, im więcej, tym lepiej.
| Algorytm | Strata log. | RMSE (bins) | AUC |
|---|---|---|---|
| FSRS-6 | 0,346 | 0,065 | 0,705 |
| FSRS-6 z parametrami domyślnymi | 0,366 | 0,093 | 0,696 |
| HLR (Duolingo) | 0,469 | 0,128 | 0,637 |
| SM-2 w wersji Anki | 0,616 | 0,172 | 0,613 |
| SM-2 | 0,722 | 0,203 | 0,603 |
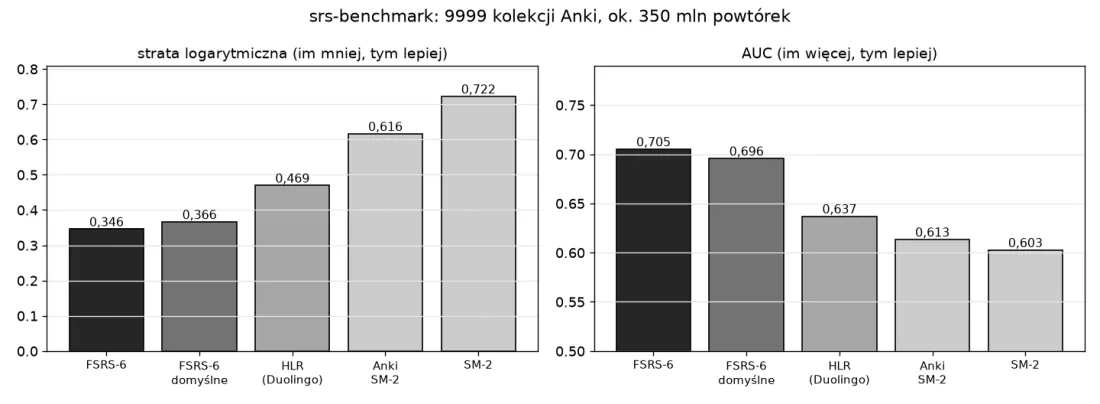
To liczby z sierpnia 2025 roku, z ostatniej tabeli, w której było jeszcze SM-2. SM-2 nie przewiduje prawdopodobieństw, więc benchmark przeliczył jego odstępy na prawdopodobieństwo i część słabej straty mierzy to przeliczenie. AUC od niego nie zależy, a i tam SM-2 jest ostatnie. Nawet FSRS-6 bez treningu, na parametrach domyślnych, wygrywa z każdą wersją SM-2. Model Duolingo, Half-Life Regression (Settles i Meeder, 2016), jest pośrodku.
Sieci neuronowe (LSTM, GRU, RWKV) w obecnej tabeli przewidują trochę lepiej od FSRS, ale mają od setek do milionów parametrów. FSRS broni się tym, że jest mały, zrozumiały i potrzebuje niewiele danych na osobę.
Jak wytrenowaliśmy FSRS na danych naszych uczniów
Nasi uczniowie powtarzają zdania z algorytmem SM-2 od 2019 roku. Dziś w naszej bazie jest 16 575 uczniów i 568 tysięcy kart. W 2026 roku użyliśmy tej historii, żeby wytrenować FSRS.
Dane. Nasz szczegółowy dziennik powtórek, z dokładnym czasem każdej odpowiedzi, obejmuje 1,21 miliona powtórek. Każdą z nich zaplanował SM-2, i to pomaga: SM-2 pokazywał karty po bardzo różnych odstępach, więc model widzi, co zostało zapamiętane po 2 dniach, po 20 i po 200. „Karta" to jeden uczeń, jedno zdanie, jeden kierunek języków. Nasza aplikacja ma trzy przyciski odpowiedzi, które odpowiadają „Nie pamiętam", „Trudno" i „Dobrze". Nie ma „Łatwo", więc dwie wagi od „Łatwo" (w3, w16) zostały domyślne. Pominęliśmy elementy oceniane automatycznie, na przykład ekrany informacyjne, które się tylko czyta, bo nie sprawdzają pamięci.
Trening. Użyliśmy py-fsrs 6.3.1, pythonowego pakietu FSRS, którego optymalizator działa na PyTorchu. Dla każdej karty pierwsze 80% powtórek szło do treningu, a ostatnie 20% zostawało do testu, więc nic z przyszłości nie przeciekało do przeszłości. Optymalizator wyliczył jeden zestaw 21 wag dla wszystkich naszych uczniów.
Test. Na 226 710 powtórkach testowych FSRS wygrał z naszym SM-2 w każdej mierze: AUC 0,686 wobec 0,597, błąd kalibracji 0,098 wobec 0,250, strata logarytmiczna 0,43 wobec 0,59 (95% przedział ufności różnicy: od −0,179 do −0,148). Wygrał też z FSRS na parametrach domyślnych.
Osiem tygodni w cieniu. Potem FSRS działał na produkcji, niczego nikomu nie pokazując. Dla każdej prawdziwej odpowiedzi liczył własny harmonogram obok SM-2. Na 164 894 odpowiedziach 1482 uczniów: AUC 0,749 wobec 0,604 dla SM-2, błąd kalibracji 0,065 wobec 0,076. Odtworzenie całej historii, 485 160 prognoz zestawionych z tym, co uczniowie naprawdę zrobili, dało AUC 0,79 i błąd kalibracji 0,053.
Wybór docelowej retencji. Odtworzenie pokazało coś przydatnego: na naszych danych FSRS jest odrobinę pesymistą. Przy celu 0,80 nasi uczniowie pamiętali naprawdę około 88,5%. Ustawiliśmy cel na 0,825, przy którym prawdziwa pamięć wychodzi około 90%. Przy tym ustawieniu FSRS potrzebuje około 0,87 powtórek planowych SM-2. Ten sam wysiłek, skierowany na karty, które go potrzebują.
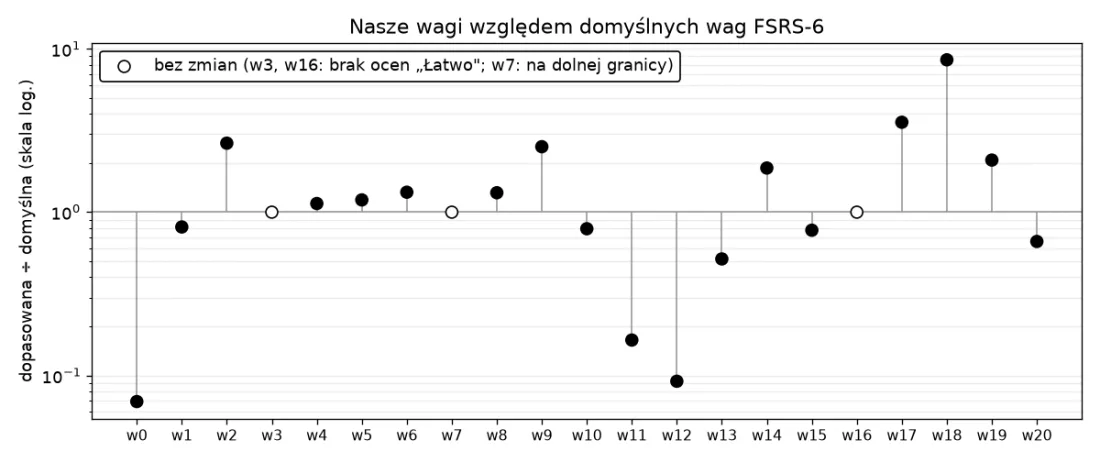
Co dopasowane wagi mówią o naszych uczniach.
- Pierwsze „Dobrze" jest mocne: stabilność po nim to 6,1 dnia, a nie 2,3. U nas „Dobrze" to najwyższy przycisk, więc niesie to, co w Anki dzielą „Dobrze" i „Łatwo".
- Pierwsze „Nie pamiętam" znika z pamięci niemal od razu (w0 = 0,015 dnia).
- Po zapomnieniu nasi uczniowie zaczynają znacznie niżej, niż zakłada wartość domyślna (w11 = 0,24 wobec 1,48).
- Powtórki tego samego dnia znaczą dużo więcej (w17, w18). Naszym zdaniem to zasługa drilla: karty, na których się pomylisz, mogą wrócić w drillu jeszcze tego samego dnia.
- Krzywa zapominania jest płaska (w20 = 0,102).
W praktyce FSRS jest odważny przy dobrze znanych kartach. Przy ustawieniach naszego pilotażu nowe zdanie, za każdym razem ocenione „Dobrze", wraca po 1, 36, 212 i 704 dniach. SM-2 pokazałby je po 1, 6, 15, 38 i 94 dniach.
Gdzie jesteśmy teraz. FSRS planuje powtórki części naszych uczniów w kontrolowanym pilotażu. Dobrana grupa porównawcza zostaje przy SM-2, a SM-2 jest domyślne, dopóki nie poznamy wyników. Znane ograniczenia: jeden zestaw wag dla wszystkich (jeszcze nie dla każdego ucznia osobno), brak odpowiedzi „Łatwo" w danych i długie pierwsze odstępy, które części uczniów mogą wydać się zbyt odważne.
Nauka języka jest inna
FSRS zakłada dwie rzeczy: każda karta to osobne wspomnienie, a wspomnienie zmienia się tylko wtedy, gdy powtarzasz tę kartę. Nauka języka łamie oba założenia, a nasze materiały dobrze to pokazują.
- Zdania zamiast słówek. Nasze karty to całe zdania. Jedno zdanie ćwiczy kilka słów i jedną konstrukcję naraz, więc przypomnienie go jest czymś więcej niż przypomnienie słówka, a sukces w jednym zdaniu pomaga w następnym.
- Czasowniki. Czasownik żyje w wielu formach. W naszych kursach tabela odmiany jednego czasownika w jednym czasie to jeden element do powtórek, obok zdań z tymi formami. Ćwiczenie „poszedłem" pomaga przy „poszli", a FSRS planuje każdą kartę tak, jakby była sama.
- Gramatyka. Punkt gramatyczny to krótkie wyjaśnienie z przykładami, a potem dziesiątki zdań. Jego „pamięć" jest rozłożona na karty, które FSRS uważa za niezależne.
- Mini historyjki. Nasze krótkie historyjki łączą zdania fabułą i możesz je czytać albo słuchać poza powtórkami. Dziennik powtórek tego nie widzi.
- Kierunek i słuchanie. Polski na norweski i norweski na polski to dwie karty, ale powiązane wspomnienia. Tryb słuchania odtwarza twoje zdania w tle, zaczynając od najtrudniejszych, co też wzmacnia pamięć między powtórkami.
To nie znaczy, że FSRS się myli. Znaczy, że przy nauce języka jego prognozy są ostrożne, i może to jeden z powodów, dla których nasi uczniowie pamiętają więcej, niż model zakłada. Modelowanie powiązań między kartami to następny otwarty problem, dla nas i dla całej dziedziny.
Co dalej: FSRS-7
FSRS się rozwija. FSRS-7 jest już w benchmarku: 34 parametry, odstępy liczone w ułamkach dnia i krzywa zapominania z ośmioma własnymi parametrami. To wersja domyślna w rozwojowej gałęzi fsrs-rs, ale w Anki jeszcze jej nie ma (srs-benchmark).
Najczęściej zadawane pytania
Co oznacza skrót FSRS?
Free Spaced Repetition Scheduler, czyli darmowy planista powtórek rozłożonych w czasie. To otwarty projekt społeczności Open Spaced Repetition, którą prowadzi Jarrett Ye.
Kto stworzył FSRS?
Jarrett Ye, na podstawie swoich badań w MaiMemo, opublikowanych na konferencji KDD 2022 i w IEEE TKDE 2023 (Ye i in., 2022). W Anki FSRS pojawił się w wersji 23.10, w październiku 2023 roku.
Czy FSRS jest lepszy niż SM-2?
W przewidywaniu wyraźnie tak: w otwartym benchmarku jego błąd jest mniej więcej trzy razy mniejszy, a na danych naszych uczniów AUC wyniosło 0,749 wobec 0,604. Czy to oznacza mniej pracy, zależy od wybranej retencji.
Czy Anki używa FSRS?
Tak, jako opcji od wersji 23.10. Obecne wersje Anki mają FSRS-6. W chwili pisania polska Wikipedia wciąż podaje, że Anki używa SM-2, ale to już nieaktualne.
Jak FSRS uczy się na moich powtórkach?
Odtwarza historię twoich powtórek karta po karcie, przed każdą powtórką przewiduje, czy pamiętasz, porównuje to z twoją odpowiedzią i poprawia 21 wag spadkiem gradientu, żeby zmniejszyć stratę logarytmiczną.
Co to jest docelowa retencja?
Prawdopodobieństwo zapamiętania, jakie chcesz mieć w chwili, gdy karta wraca. Zwykle to 90%. Wyższa wartość szybko zwiększa liczbę powtórek.
Czy Taalhammer używa FSRS?
Nasz domyślny algorytm to wariant SM-2. FSRS wytrenowany na powtórkach naszych uczniów planuje powtórki części uczniów w kontrolowanym pilotażu.
Gdzie czytać dalej
Najlepsze źródło techniczne to wiki Open Spaced Repetition, The Algorithm, oraz techniczne wyjaśnienie autorstwa Expertium (po angielsku). Jeśli przechodzisz z Anki, zobacz import z Anki. Jak wybieramy następne zdanie do nauki, opisujemy w tekście o algorytmie n+1.