Jak AI ocenia wymowę: modele, dane i dokładność

Automatyczna ocena wymowy nie słucha tak jak nauczyciel. Model mowy ustala, jakie dźwięki wypowiedziałeś. Potem dopasowuje je do dźwięków, które powinny paść, i ocenia, jak bardzo każdy z nich pasuje. Dla całych zdań najlepsze systemy zgadzają się z ekspertami na poziomie około 0,74–0,78, blisko tego, jak zgadzają się ze sobą ludzie. Dla pojedynczych głosek są dużo słabsze.
Spis treści
- Dlaczego chciałem zajrzeć do środka
- Jak działa automatyczna ocena wymowy
- Goodness of Pronunciation (GOP), czyli serce oceny
- Na jakich danych uczy się ocena wymowy
- Od GOP do modeli end-to-end i audio-LLM-ów
- Kto oferuje ocenę wymowy
- Ile można ufać automatycznej ocenie wymowy
- Dlaczego własne ucho nie wystarcza
- Czy to naprawdę pomaga w nauce
- Jak korzystać z oceny wymowy
- Najczęściej zadawane pytania
Dlaczego chciałem zajrzeć do środka
Zrobiłem specjalizację z fonetyki eksperymentalnej i pisałem kiedyś programy do automatycznej transkrypcji fonetycznej. W Taalhammerze korzystamy dziś z komercyjnej usługi oceny wymowy. Zanim pokażemy uczniom jej liczby, chciałem dokładnie wiedzieć, co znaczą. Ten tekst to odpowiedź: jak ta technologia działa, na jakich danych się uczy, kto ją sprzedaje i na ile można jej ufać. Praktyczne porady o nagrywaniu siebie znajdziesz w tekście słyszeć siebie.
Jak działa automatyczna ocena wymowy
Prawie każdy system działa według tego samego schematu. Czytasz podane zdanie, a system porównuje nagranie z tym, jak to zdanie powinno brzmieć.
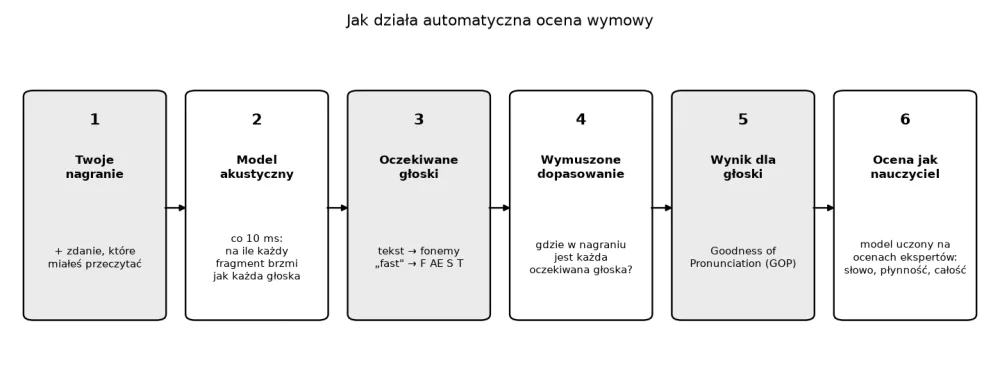
- Model akustyczny. Sieć neuronowa uczona na wielu godzinach mowy (głównie rodzimych użytkowników) co 10 milisekund szacuje, na ile dany fragment brzmi jak każda głoska.
- Oczekiwane głoski. Tekst zamienia się na fonemy według słownika wymowy. Angielskie fast to F AE S T.
- Wymuszone dopasowanie. System szuka, gdzie w nagraniu jest każda oczekiwana głoska. Nie pyta „co powiedziałeś?", tylko „gdzie jest F, a gdzie AE?".
- Wynik dla każdej głoski. Dla każdego fragmentu ocenia, na ile model jest pewny, że to właściwa głoska, a nie inna.
- Ocena jak nauczyciel. Ostatni model, uczony na ocenach ekspertów, zamienia wyniki głosek, pauzy i melodię w ocenę słowa, płynności i całości.
Jeden skutek zaskakuje. W tym trybie maszyna słucha zdania, którego się spodziewa. Powiesz inne słowo, nawet idealnie, a dostaniesz ocenę złej wersji słowa oczekiwanego. Dlatego dostawcy mają osobny tryb bez skryptu, który najpierw musi zgadnąć, co powiedziałeś.
Goodness of Pronunciation (GOP), czyli serce oceny
Krok 4 ma swoją nazwę. W 2000 roku Silke Witt i Steve Young z Cambridge zdefiniowali Goodness of Pronunciation jako znormalizowany względem czasu trwania logarytm prawdopodobieństwa, że mówca wypowiedział oczekiwaną głoskę (Witt i Young, 2000). Prościej: na ile oczekiwana głoska jest bardziej prawdopodobna od najlepszej konkurencyjnej.
Ich najlepszy system zgadzał się z oceniającymi na poziomie 0,72 dla pojedynczych głosek. Oceniający zgadzali się między sobą na poziomie 0,78. Ta różnica na poziomie pojedynczej głoski nie zniknęła do dziś.
GOP stale się rozwija:
- Sieci neuronowe zastąpiły starsze modele statystyczne. Praca Microsoft Research Asia o GOP na sieciach neuronowych (Hu i in., 2015) dostała nagrodę ISCA za najlepszy artykuł.
- GOP bez segmentacji. Nowoczesne modele mowy uczone metodą CTC dają „szpiczaste" wyniki, które trudno podzielić na głoski. Badacze z NTNU w Trondheim zaproponowali wersję GOP, która bierze pod uwagę wszystkie możliwe podziały (Cao, Fan, Svendsen i Salvi). GOP oparty na CTC wygrał też w 2025 roku norweskie wyzwanie oceny wymowy dzieci NOCASA.
Sami używamy tej idei w drugą stronę. Żeby sprawdzić, czy lektor AI poprawnie wymawia parę minimalną, pytamy model mowy, która z dwóch pisowni lepiej pasuje do nagrania. Opisujemy to w tekście o tym, jak testujemy lektorów AI.
Na jakich danych uczy się ocena wymowy
To część, której nikt nie tłumaczy, a decyduje o wszystkim. System potrzebuje dwóch rodzajów danych:
- Dużo mowy rodzimych użytkowników, żeby model akustyczny wiedział, jak brzmią poprawne głoski. Takich danych jest mnóstwo.
- Mowy uczniów ocenionej przez ekspertów, żeby ostatni model naśladował ocenę nauczyciela. Takich danych jest mało i są drogie.
Standardowa recepta to więc duży model akustyczny na mowie rodzimej i mały model oceniający na niewielkim zbiorze ocenionej mowy uczniów. Najważniejsze zbiory danych:
| Zbiór | Co zawiera | Jak jest opisany |
|---|---|---|
| TIMIT | 630 rodzimych użytkowników amerykańskiego angielskiego | ręcznie sprawdzona transkrypcja fonetyczna z czasem każdej głoski |
| LibriSpeech | ok. 1000 godzin angielskich audiobooków | tylko tekst; do uczenia modeli akustycznych |
| L2-ARCTIC | 24 osoby mówiące po angielsku jako obcym | w 3599 zdaniach oznaczono 14 098 podmienionych, 3420 opuszczonych i 1092 dodane głoski |
| speechocean762 | 5000 angielskich zdań od 250 uczniów z chińskim jako ojczystym, połowa to dzieci | 5 ekspertów oceniło każde zdanie: głoskę 0–2, słowo 0–10, zdanie za dokładność, płynność, kompletność i prozodię |
| NB Tale | norweska baza mowy, 380 osób | w tym 120 osób mówiących po norwesku jako obcym, opis głoska po głosce |
| TeflonNorL2 / NOCASA | 10 334 nagrania dzieci mówiących 205 norweskich słów | eksperci ocenili każde w skali 1–5 |
Dwa szczegóły pokazują, jak trudna jest anotacja fonetyczna. Eksperci speechocean762 najpierw głosowali, która wymowa słowa jest „poprawna", żeby brytyjska samogłoska nie dostała kary wobec amerykańskiego wzorca. Poza tym oceny są przesunięte w górę: większość głosek i słów dostaje wysokie noty, więc model widzi mało wyraźnych błędów.
Mało danych widać w wynikach. W norweskim wyzwaniu NOCASA najlepszy system trafiał we właściwą ocenę 1–5 z czułością zbalansowaną zaledwie 44,8% (NOCASA).
Od GOP do modeli end-to-end i audio-LLM-ów
Nowsze systemy uczą się większej części tego łańcucha naraz. Dwa wyniki pokazują stan dziedziny:
- GOPT (MIT, 2022) podaje cechy GOP każdej głoski do małego Transformera i przewiduje wszystkie oceny jednocześnie. Na speechocean762 zgadza się z ekspertami na poziomie około 0,61–0,68 dla głoski i 0,74 dla zdania, ale tylko 0,29 dla akcentu wyrazowego (Gong i in., 2022).
- Modele, które wskazują złą głoskę. Dostrojone modele mowy (wav2vec 2.0) wykrywają pojedyncze błędy z F1 około 0,61 na L2-ARCTIC (Xu i in., 2021).
A audio-LLM-y? W badaniu Microsoftu z 2025 roku model językowy z dźwiękiem, bez uczenia do tego zadania, oceniał wymowę słów z korelacją −0,03, czyli bez żadnego sygnału. Po dostrojeniu na ocenionych danych doszedł do 0,77–0,78 dla zdania, ale tylko 0,39 dla głoski (Microsoft, 2025). Nasz test modeli audio OpenAI na norweskich parach minimalnych dał podobny obraz: wyniki bliskie zgadywania.
Kto oferuje ocenę wymowy
| Dostawca | Co dostajesz | Języki | Co wiadomo o modelu |
|---|---|---|---|
| Microsoft Azure Pronunciation Assessment | dokładność, płynność, kompletność, ocena ogólna; błędy słów (opuszczone, dodane, źle wymówione); ocena każdego fonemu | 33 lokale, w tym norweski bokmål; prozodia i „jaką głoskę naprawdę usłyszano" tylko dla amerykańskiego angielskiego | architektura nieopublikowana; badacze Microsoftu podają 0,62 dla słowa i 0,78 dla zdania wobec ekspertów na speechocean762 (dokumentacja) |
| Speechace | oceny głosek, sylab i słów, akcent, płynność, przeliczenie na IELTS/CEFR | warianty angielskiego, francuskiego, hiszpańskiego | zastrzeżony; deklaracja 0,9 zgodności z oceniającymi bez publikacji (cennik) |
| SpeechSuper | oceny od głoski do akapitu, akcent, płynność | 8 języków | nieopublikowany |
| ELSA | własny silnik w aplikacji | angielski | nieopublikowany |
| Langcraft | zamiana mowy na IPA ze znacznikami czasu i wykrytymi podmianami, wstawieniami i opuszczeniami | deklarowane „ponad 40 języków" | berliński start-up z 2026 roku; bez publikacji i publicznych cen (langcraft.world) |
Google, Apple i Amazon oferują rozpoznawanie mowy, ale nie znaleźliśmy u nich publicznego API do oceny wymowy.
Czego używamy: Taalhammer korzysta z Azure Pronunciation Assessment. Azure daje każdej głosce ocenę dokładności, ale nie mówi wprost, czy głoska jest poprawna, podmieniona, opuszczona czy dodana. Tę etykietę wyprowadzamy sami. Głoska z wynikiem poniżej 80 w skali 0–100 Azure liczy się jako błędna. Słowa, które Azure zgłasza jako opuszczone albo dodane, oznaczają tak wszystkie swoje głoski. Sam Azure uznaje słowo za źle wymówione poniżej 60 i zaleca dobierać progi do ucznia, łagodniej dla dzieci.
Ile można ufać automatycznej ocenie wymowy
| Porównanie | Zgodność z ekspertami |
|---|---|
| Oceniający między sobą, pojedyncze głoski (Witt i Young) | 0,78 |
| GOP z 2000 roku, pojedyncze głoski | 0,72 |
| GOPT z 2022 roku, głoska / całe zdanie | 0,61–0,68 / 0,74 |
| Azure na speechocean762, słowo / zdanie | 0,62 / 0,78 |
| Dostrojony audio-LLM, głoska / zdanie | 0,39 / 0,77–0,78 |
| Audio-LLM bez uczenia do zadania, słowa | −0,03 |
Wzór jest stały. Oceny całych zdań są wiarygodne, werdykty dla pojedynczych głosek chwiejne, i to u maszyn, i u ludzi. Wynik zależy też od wzorcowego akcentu, języka ojczystego ucznia, surowości pierwotnych oceniających i od tego, czy mówi dziecko.
Jest też głębsze zastrzeżenie. Wysoka „dokładność" mierzy głównie to, jak blisko brzmisz do wzorca rodzimego, a nie to, czy ktoś cię rozumie. Munro i Derwing pokazali w klasycznym badaniu, że akcent, łatwość rozumienia i faktyczna zrozumiałość są powiązane, ale częściowo niezależne. Mowa może mieć silny akcent i być w pełni zrozumiała (Munro i Derwing). Wielu nauczycieli przyjmuje za Johnem Levisem, że celem jest być zrozumianym, a nie brzmieć jak rodzimy użytkownik. Wynik 70 może oznaczać zupełnie jasną mowę.
Dlaczego własne ucho nie wystarcza
Po co więc maszyna? Bo słabo oceniamy własną mowę:
- Słyszysz inny głos. Kiedy mówisz, dźwięk dociera do ucha wewnętrznego także przez kości czaszki, co wzmacnia niskie tony. Nagranie tego nie ma, więc brzmi cieniej niż głos, który znasz (Acoustical Society, 2013).
- Słabsi się przeceniają, mocniejsi nie doceniają. W badaniu 134 uczniów samoocena akcentu i zrozumiałości była w większości błędna, właśnie według tego wzoru (Trofimovich i in., 2016).
- Ucho steruje ustami. Gdy badacze przesuwali mówiącym samogłoski w słuchawkach, ci nieświadomie zmieniali artykulację, żeby to wyrównać (omówienie eksperymentu Houde'a i Jordana). Haczyk: poprawisz tylko to, co twoje ucho potrafi wychwycić.
Dla Polaka to szczególnie ważne. Jeśli angielskie th brzmi dla ciebie jak s albo f, a cat jak cut, nie zauważysz własnego błędu. Dlatego warto ćwiczyć pary minimalne, o czym piszemy na przykładzie wymowy norweskiej. Więcej o nagrywaniu siebie: słyszeć siebie.
Czy to naprawdę pomaga w nauce
Tak, ale pod warunkami. Metaanaliza 86 badań pokazała, że nauczanie wymowy ma duży efekt (d = 0,89), większy przy informacji zwrotnej (Lee, Jang i Plonsky, 2015). Dla ćwiczeń z rozpoznawaniem mowy metaanaliza z 2024 roku wykazała średni efekt (g = 0,69). Najlepiej działała jawna informacja zwrotna o pojedynczych głoskach (0,86). Głoski poprawiały się lepiej niż intonacja i rytm (0,82 wobec 0,37). Ćwiczenie z partnerem dawało więcej niż w pojedynkę (0,89 wobec 0,44) (Ngo, Chen i Lai, 2024).
Jak korzystać z oceny wymowy
- Patrz na głoski, nie na jedną liczbę. Które głoski stale wypadają słabo? To twoja lista.
- Traktuj ocenę słowa jak sygnał, nie wyrok. Werdykty dla pojedynczych głosek to najmniej pewna część systemu.
- Najpierw ucho. Ćwicz trudne głoski jako pary minimalne, potem nagraj siebie.
- Celem jest bycie zrozumianym. Akcent i zrozumiałość to nie to samo.
Jeśli zapis fonemów jest dla ciebie nowy, zajrzyj do naszego przewodnika po alfabecie fonetycznym IPA.
Najczęściej zadawane pytania
Jak działa sprawdzanie wymowy w aplikacjach?
Aplikacja dopasowuje nagranie do głosek zdania, które miałeś przeczytać. Ocenia, jak bardzo każda głoska pasuje do modelu mowy rodzimej, i zamienia te wyniki w oceny słów i zdań nauczone na ocenach ekspertów.
Na ile dokładna jest ocena wymowy przez AI?
Dla całych zdań najlepsze systemy zgadzają się z ekspertami na poziomie około 0,74–0,78, blisko 0,78, które osiągnęli między sobą ludzie w klasycznym badaniu. Dla pojedynczych głosek zgodność jest niższa, około 0,6–0,7, a niektóre modele wypadają dużo gorzej.
Na jakich danych uczą się modele oceny wymowy?
Modele akustyczne uczą się na dużej ilości mowy rodzimych użytkowników, na przykład z audiobooków. Warstwa oceniająca uczy się na mniejszych zbiorach mowy uczniów ocenionej przez ekspertów, takich jak speechocean762 czy L2-ARCTIC.
Czy ocena wymowy w Azure jest dobra?
Obejmuje 33 lokale, w tym norweski bokmål. Według badaczy Microsoftu zgadza się z ekspertami na poziomie 0,78 dla całych zdań na standardowym angielskim zbiorze testowym. Ocena prozodii i podpowiedzi głosek działają tylko dla amerykańskiego angielskiego.
Czy aplikacja rozpozna, że mam akcent?
Potrafi zmierzyć, jak daleko twoje głoski są od jej rodzimego wzorca. To bliskie mierzeniu akcentu. Nie mierzy wprost, czy ludzie cię rozumieją, a to jest najważniejsze.