Wie wir Handschrifterkennung für 7 Alphabete gebaut haben
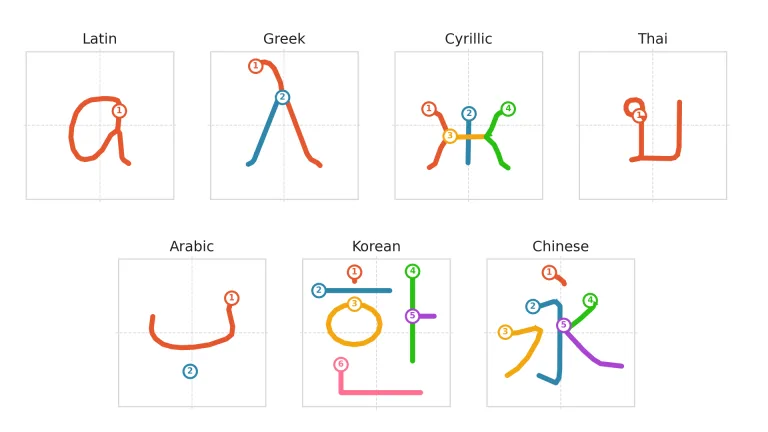
Wir haben eine Handschrifterkennung gebaut, die prüft, wie Lernende Buchstaben und Zeichen in sieben Schriften schreiben. Angefangen haben wir mit einem großen Sprachmodell, und schon am ersten Tag haben wir es verworfen. Heute arbeitet ein kleines Sequenznetz mit rund 0,8 Millionen Parametern pro Schrift. Es liest den Weg deines Fingers. Darüber sitzt ein durchschaubarer Richter. Das Ganze läuft auf unseren Servern ohne Grafikkarte und antwortet in 40–100 ms. In unseren Tests akzeptiert es 95–99 % der richtigen Zeichnungen in fünf Schriften und verwechselt fast nie ein Zeichen mit einem ähnlichen. So sind wir dorthin gekommen, mit allen Fehlern.
Inhalt
- Was die Übung Schreiben von einer Maschine braucht
- Versuch 1: ein großes Sprachmodell fragen
- Versuch 2: Vorlagen vergleichen und einen Richter entscheiden lassen
- Ein kleines Bildnetz dazu
- Vom Bild zum Weg des Stifts
- Die Prüfung: Unsere eigenen Zahlen logen
- Das Sequenznetz, das funktioniert hat
- Wie das Netz lernt zu sagen: „Das ist kein Zeichen“
- Woher die Trainingsdaten kommen
- Training auf einem einzigen Laptop
- Wie wir messen und wann ein Modell gewinnt
- Die Ergebnisse für jede Schrift
- Was es noch nicht kann
- FAQ
Was die Übung Schreiben von einer Maschine braucht
In der Übung Schreiben in Taalhammer zeichnest du ein Zeichen mit dem Finger oder einem Stift, und die App sagt dir, ob es stimmt. Das klingt nach einem gelösten Problem. Handys haben schließlich Tastaturen für Handschrift. Aber eine Tastatur muss nur erraten, welches Zeichen du meinst. Wir müssen beurteilen, wie du es geschrieben hast.
Die Maschine muss also vier Dinge können:
- Das Zeichen erkennen, in Latein, Griechisch, Kyrillisch, Thai, Arabisch, Koreanisch und Chinesisch.
- Ein ähnliches Zeichen ablehnen. Wer з schreibt, wenn э gefragt ist, darf nicht bestehen, auch wenn die Formen nah beieinander liegen.
- Eine unvollständige oder kaputte Zeichnung ablehnen: einen fehlenden Strich, eine zusätzliche Linie, einen gespiegelten Buchstaben.
- Dich nie wegen der Strichreihenfolge durchfallen lassen. Sie darf höchstens einen Hinweis geben.
Die letzte Regel kommt aus der Forschung. Buchstaben von Hand zu schreiben hilft beim Lernen weit mehr als Tippen oder Anschauen. Erwachsene, die arabische Buchstaben lernten, benannten nach dem Schreibtraining 93 % richtig, nach dem Tippen 86 % und nach dem Anschauen 83 % (Wiley & Rapp, 2021). Freies Schreiben wirkt besser als das Nachfahren einer Vorlage (James & Engelhardt, 2012). Dass eine bestimmte Strichreihenfolge hilft, ist dagegen nicht eindeutig belegt. Eine feste Reihenfolge schadete sehr kleinen Kindern (Merritt et al., 2020), und Animationen der Strichreihenfolge senkten bei Erwachsenen, die Chinesisch lernten, die Erkennung (Hou & Jiang, 2022). Deshalb schreibst du in der Übung auf ein leeres Kästchen statt auf eine Vorlage, und der Prüfer bewertet die Form, nicht die Reihenfolge.
Dazu kommen die technischen Anforderungen. Dieselbe Zeichnung muss immer dasselbe Urteil bekommen. Eine Prüfung darf nichts kosten und muss deutlich unter einer Viertelsekunde bleiben. Und alles muss auf unseren normalen API-Servern laufen.
Versuch 1: ein großes Sprachmodell fragen
Der schnellste Prototyp schickte jede Zeichnung als Bild an ein großes Sprachmodell. Er fragte, welches Zeichen das ist und wie gut es geschrieben ist. Auf seine Art funktionierte das. Ein sauberes a erkannte das Modell mit einer Sicherheit von 0,97, ein schlampiges bewertete es niedrig.
Aber jede Antwort dauerte 2,7–4,4 Sekunden, und jeder Klick kostete Geld. Am schlimmsten war, dass dieselbe Zeichnung jedes Mal eine andere Bewertung bekam. Wer zweimal auf „Prüfen“ drückt und zwei Urteile bekommt, vertraut der Übung nicht mehr. Wir haben das noch am selben Tag aufgegeben.
Versuch 2: Vorlagen vergleichen und einen Richter entscheiden lassen
Die zweite Version verglich Vorlagen. Wir nutzten den $P-Punktwolken-Erkenner (Vatavu, Anthony & Wobbrock, 2012). Er macht aus einer Zeichnung eine Wolke von Punkten und sucht die nächste gespeicherte Vorlage. Wir kannten ihn schon aus unseren Alphabet-Kursen.
Der erste echte Test, ein von Hand nachgezeichnetes thailändisches ก, ergab null Punkte. Unsere automatischen Tests waren zu gnädig gewesen. Die Vorlage, aus einer Schriftart gebaut, zerfiel in vier Stücke. Leicht verwackelte Kopien einer kaputten Vorlage passen trotzdem perfekt zueinander. Die Tests liefen durch, echte Zeichnungen fielen durch.
Wir haben das Ganze deshalb auf Messungen statt auf einen einzigen Abstand umgebaut. Für jede Zeichnung berechnen wir etwa ein Dutzend Zahlen: wie nah sie am Ziel liegt im Vergleich zum nächsten anderen Zeichen, wie viel Tinte fehlt oder zu viel ist, ob es einen verirrten Strich gibt, wie viele Punkte und Striche sie hat. Eine logistische Regression, eine pro Schrift, macht aus diesen Zahlen ein Urteil.
Zwei Lehren nahmen wir aus dieser Phase mit:
- Schwellenwerte stoßen an eine Decke. Ein strengerer Schwellenwert für einen einzigen Abstand senkte die Fehler nur, indem er gute Zeichnungen ablehnte. Der Anteil akzeptierter richtiger lateinischer Buchstaben fiel von 81 % auf 68 %.
- Die Strichreihenfolge darf nicht ins Urteil. Als unsere synthetischen Schreiber die Strichreihenfolge variierten, brach die Annahme richtiger koreanischer und chinesischer Zeichnungen auf 40 % und 47 % ein. Unser Strichmaß hing noch von der Reihenfolge ab. Eine reihenfolgefreie Version, die Striche unabhängig von ihrer Abfolge einander zuordnet, brachte beide auf etwa 71 % zurück.
Ein kleines Bildnetz dazu
Den günstigsten großen Gewinn brachte ein kleines faltendes neuronales Netz (CNN). Es betrachtet ein 32×32-Bild der Zeichnung und gibt an, wie wahrscheinlich jedes Zeichen ist. Es hat rund 190.000 Parameter, wiegt etwa 270 kB pro Schrift und läuft in reinem numpy, die API braucht also keine Bibliothek für maschinelles Lernen. Seine Sicherheit wurde zu zwei zusätzlichen Eingaben für den Richter.
Die Annahme ähnlicher Zeichen fiel von 1–3 % auf fast null. Der Anteil akzeptierter richtiger Thai-Zeichnungen stieg von 83 % auf 98 %, bei Koreanisch von 75 % auf 89 %.
Vom Bild zum Weg des Stifts
Ein Bild wirft Information weg. Auf dem Handy wissen wir, wo jeder Strich beginnt, in welche Richtung er läuft und wo sich der Finger hebt. Die Erkennung aus diesem Weg heißt Online-Handschrifterkennung, im Unterschied zur Offline-Erkennung aus einem Bild.
Unser erstes Sequenznetz las 96 Punkte entlang des Weges durch vier Faltungsschichten. Es wog höchstens 316 kB und lief in etwa einer Millisekunde. Wir haben es mit dem Bildnetz auf denselben Daten verglichen, Schrift für Schrift. Das Sequenznetz gewann bei fünf Schriften, das Bildnetz blieb vorerst für Kyrillisch und Thai.
Das Problem war Chinesisch. Bei 1.200 Zeichen, von denen sich viele nur in einem Strich unterscheiden, akzeptierte die Engine in unseren Tests nur 63 % der richtigen Zeichnungen. Das richtige Zeichen stand nur in 46 % der Fälle an erster Stelle.
Die Prüfung: Unsere eigenen Zahlen logen
Bevor wir zu einem größeren Modell griffen, haben wir geprüft, wie wir messen. Wir fanden zwei Fehler, durch die wir besser aussahen, als wir waren:
- Der Validierungssatz war undicht. Wir hatten Zeichnungen aufgeteilt, nicht Schreiber. Die Handschrift derselben Person landete auf beiden Seiten des Tests.
- „Zufällige“ echte Schreiber waren nicht zufällig. Es waren die ersten Personen in einer Datei.
Nachdem wir beides behoben hatten, wurden die Zahlen erst einmal schlechter. Die Prüfung zeigte auch, wo wir wirklich verloren. Der Engpass war der Richter, nicht das Netz. Er war an synthetischen Zeichnungen angepasst und las „richtig, aber unsicher“ als „falsch“. So lehnte er etwa 40 % der Zeichnungen ab, die das Netz richtig erkannt hatte.
Das Sequenznetz, das funktioniert hat
Das zweite Sequenznetz war der Wendepunkt. Es ist das, was heute läuft.
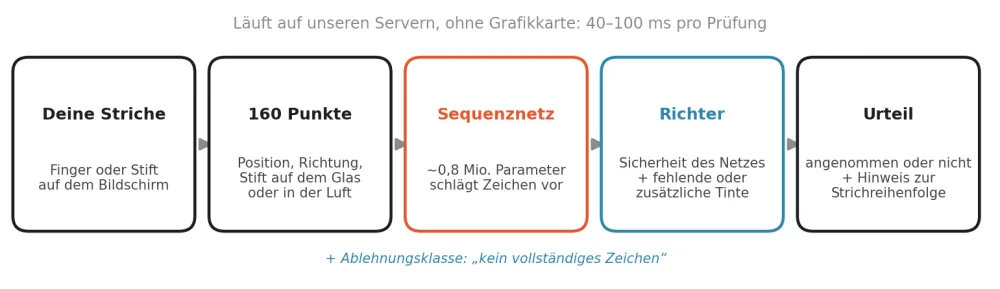
Die Eingabe. Wir rechnen die Zeichnung auf 160 Punkte um. Jeder Punkt trägt seine Position, die Bewegung des Stifts, seine Ausrichtung (in einer Form, die sich nicht ändert, wenn ein Strich rückwärts gezogen wird), den Sprung des Stifts in der Luft zwischen zwei Strichen und ein Kennzeichen für angehobenen Stift. Das alte Netz hatte die Sprünge in der Luft weggeworfen.
Das Netz. Es ist ein residuales eindimensionales CNN mit 128 Kanälen. Seine Schichten sind gestreut: Sie schauen auf Punkte im Abstand von 1, 2, 4 und 8, und das zweimal. So sieht jede Ausgabe den ganzen Weg. Das alte Netz sah nur 17 seiner 96 Punkte auf einmal. Statt eines einfachen Klassifikators lernt das Netz zwei Prototypen pro Zeichen und bewertet eine Zeichnung danach, wie nah sie jedem davon ist.
Das Training. Wir stören die Strichreihenfolge so, wie Menschen es tun: Manchmal tauschen wir benachbarte Striche, selten drehen wir einen um. Zufällige Verzerrungen sind anfangs stark und klingen bis zum Ende des Trainings auf null ab, damit das Netz mit sauberen Formen endet. Ein chinesisches Modell trainiert 40 Epochen lang.
Die Auslieferung. Für den Einsatz falten wir die Normalisierungsschichten in die Faltungen und exportieren die Gewichte nach numpy. Ein Modell wiegt 1,5–2,1 MB pro Schrift, hat rund 0,8 Millionen Parameter, und ein Durchlauf dauert auf einem Prozessor etwa 5 ms.
Zwei Änderungen rund um das Netz waren so wichtig wie das Netz selbst:
- Das Netz schlägt die Kandidaten vor. Der Vorlagenvergleich ordnet sie nur noch und erklärt sie. Allein das hob die koreanische Erkennung von 53,4 % auf 95,5 %.
- Der Richter darf Unordnung nicht belohnen. Sich selbst überlassen, lernte die Regression, dass echte Schreiber viel fehlende und überschüssige Tinte hinterlassen. Sie gab diesen Merkmalen positive Gewichte und lehnte 42 % perfekter Lehrbuchzeichnungen ab. Jetzt geben wir das Vorzeichen jedes Gewichts vor. Fehlende Tinte kann eine Bewertung nur senken.
Bei Chinesisch stieg der Anteil akzeptierter richtiger Zeichnungen von 63,3 % auf 96,7 % und die Erkennung von 46,1 % auf 97,7 %. Aber das Netz las unordentliche Schrift inzwischen so gut, dass es auch unvollständige Zeichnungen las. Der Anteil akzeptierter fehlerhafter Zeichnungen stieg von 15,6 % auf 29,5 %.
Wie das Netz lernt zu sagen: „Das ist kein Zeichen“
Die Lösung war eine zusätzliche Ablehnungsklasse. Das Netz lernt, wie eine kaputte Zeichnung aussieht, und kann „keins davon“ antworten. Bis zur richtigen Version brauchten wir fünf Anläufe.
大 ohne einen Strich ist 人. Das erste Netz mit Ablehnung fing an, ein richtiges 人 abzulehnen. Wir hatten „大 mit fehlendem Strich“ als Fehler markiert, und genau diese Zeichnung ist 人.
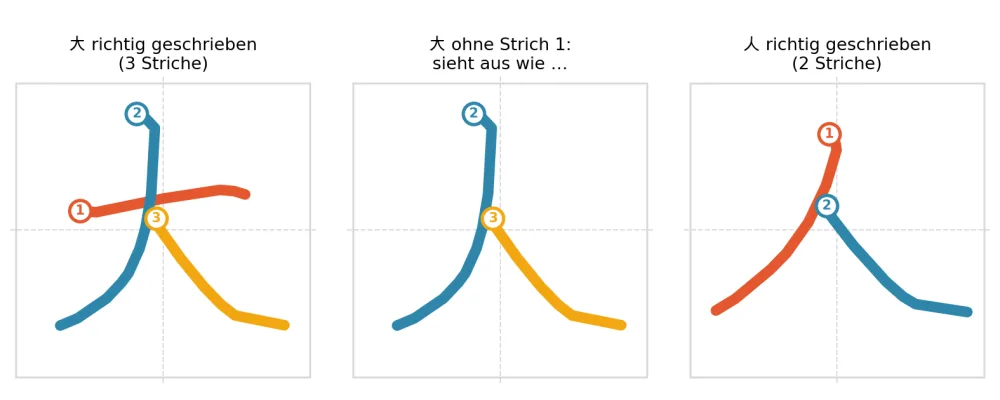
Deshalb filtern wir die Fehler. Ein älteres Netz ohne Ablehnungsklasse liest jeden erzeugten Fehler. Erkennt es darin mit mindestens 50 % Sicherheit ein anderes echtes Zeichen, fliegt der Fehler raus. Das traf etwa 16 % von ihnen.
Lernende schreiben wie im Lehrbuch. Muttersprachliche Erwachsene nicht. Die nächste Version verwechselte 6 % perfekter Lehrbuchzeichen und las 爸 mit 99,9 % Sicherheit als 职. Ein Netz, das auf flüssiger, schneller Schrift von Erwachsenen trainiert ist, hat die sorgfältige Lehrbuchform selten gesehen, und genau die schreiben Lernende. Wir haben 200 synthetische Zeichnungen pro Zeichen hinzugefügt, davon 40 % nahe am Lehrbuch, und danach 12 exakte Lehrbuchkopien pro Zeichen.
Der endgültige Generator erzeugt sechs Arten von Fehlern in festen Anteilen: einen fehlenden Strich (28 %), einen zusätzlichen Strich (23 %), einen von einem anderen Zeichen geliehenen Strich (14 %), eine abgeschnittene Zeichnung (14 %), eine gespiegelte (7 %) und eine gedrehte (7 %). Gekritzel kam später dazu.
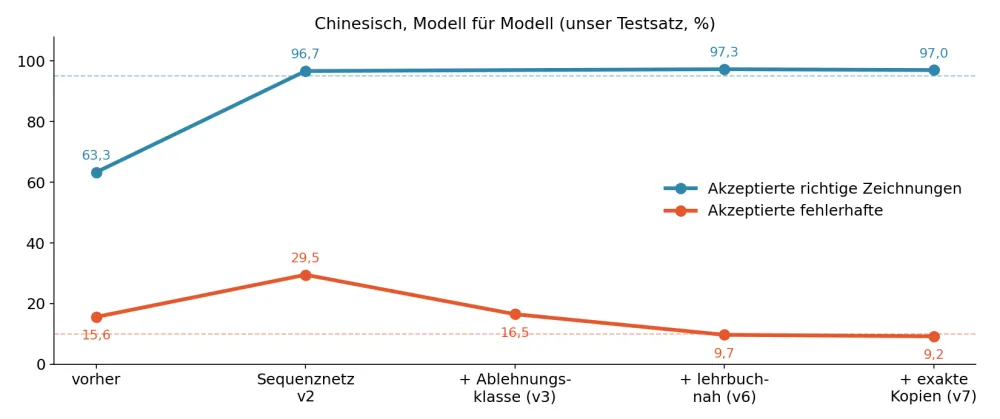
Das chinesische Modell in der App akzeptiert 97,0 % der richtigen Zeichnungen, lässt 9,2 % der fehlerhaften durch und erkennt 97,6 % der Zeichen. Exakte Lehrbuchzeichnungen akzeptiert es zu 100 %. Am 14. Oktober haben wir alle anderen Schriften auf dasselbe Rezept umgestellt.
Woher die Trainingsdaten kommen
Wir nennen nur Daten, die jede und jeder herunterladen kann:
| Quelle | Inhalt | Lizenz |
|---|---|---|
| UNIPEN | echte Stiftaufzeichnungen lateinischer Buchstaben | CC BY 4.0 |
| UJI Pen Characters | echte Stiftaufzeichnungen lateinischer Buchstaben | CC BY 4.0 |
| Omniglot | Zeichnungen von 20 Personen pro Alphabet, darunter Griechisch und Kyrillisch | MIT |
| Make Me a Hanzi | Strichdaten für über 9.000 chinesische Zeichen | Arphic PL / LGPL |
| Noto und andere offene Schriften | Buchstabenformen in allen Schriften | SIL OFL |
Für Thai, Arabisch, Koreanisch, Griechisch und Kyrillisch gibt es keine freie Sammlung echter Stiftstriche, die groß genug zum Trainieren wäre. Für Thai gibt es überhaupt keine öffentliche Sammlung von Stiftaufzeichnungen. Also haben wir eine synthetische Hand gebaut. Wir haben die Musterformen auf 3.285 echte Zeichnungen aus UNIPEN gelegt und gemessen, wie Menschen Buchstaben verzerren: eine typische Neigung von ±13°, Schräglage, gestreckte Proportionen und ein Zittern von etwa 3 % der Buchstabengröße. Etwa 8 % der Schreiber verbinden Striche, die die Vorlage trennt. Echte Schrift war zwei- bis dreimal unordentlicher, als wir angenommen hatten. Die Annahme dahinter: Dasselbe Handgelenk schreibt Thai und Latein. Eine angepasste Hand schreibt also jedes Zeichen in jeder Schrift, tausende Male.
Schriftarten erwiesen sich als schlechte Lehrer. Sie beschreiben Umrisse, keine Bewegungen. Als wir Strichdaten für Koreanisch aus Schriftumrissen bauten, hatten 36 % der Silben die falsche Strichzahl. Wir haben die Strichdaten nach Unterrichtsstandards neu aufgebaut.
Training auf einem einzigen Laptop
Wir trainieren alles nachts auf dem Grafikchip eines einzigen Laptops (ein M1 Pro mit 16 GB Speicher, den er mit dem Rest des Systems teilt). Für dieses Netz ist das 19-mal schneller als der Prozessor des Laptops: 8 Minuten pro Million Zeichnungen statt 151. Ein Training für Chinesisch dauert zwei bis sieben Stunden, für Latein unter einer halben Stunde.
Der Laptop ist auch ein Arbeitsrechner, deshalb läuft das Training unter einem Wächter. Er beobachtet den Speicherdruck und pausiert oder sichert das Training, bevor das System auslagern muss. Jeder Trainings- und Testlauf wird mit seinen Einstellungen und Ergebnissen gespeichert. In fünf Tagen kamen über 150 davon zusammen.
Was schiefging:
- Ein Schritt zum Aufbau der Daten hing sieben Stunden. Die Arbeitsprozesse waren per Fork gestartet worden, nachdem die Grafikbibliothek schon lief, und blockierten sich gegenseitig. Der einzige Alarm, den wir gesetzt hatten, lautete „Sag Bescheid, wenn es klappt“. Jetzt hat jedes Warten auch ein Zeitlimit.
- Zu viele Rechen-Threads ließen die Datenerzeugung 23 Minuten statt einer dauern. Jeder Arbeitsprozess bekommt jetzt einen Thread.
- Unser Vergleichswerkzeug bewertete ein neues Modell mit den Messungen des alten. Drei Urteile waren falsch und mussten wiederholt werden.
Wie wir messen und wann ein Modell gewinnt
Jede Schrift hat ein beschriftetes Testkorpus aus zwei Teilen, die nie einen Schreiber teilen:
- TUNE ist der einzige Teil, auf dem wir Entscheidungen treffen.
- HOLDOUT dient nur dem Bericht. Würden wir darauf abstimmen, hörte er auf, die Wahrheit zu sagen.
Jeder Teil enthält richtige Zeichnungen von sorgfältig bis schlampig, ähnliche Zeichen (eine gute Zeichnung eines anderen Zeichens), Fehler und Gekritzel. Wir messen:
| Maß | Bedeutung | Ziel |
|---|---|---|
| Richtige akzeptiert | richtige Zeichnungen, sorgfältig bis recht schlampig, die bestehen | ≥ 95 % |
| Ähnliche akzeptiert | ein anderes Zeichen wird als Ziel akzeptiert | ≤ 0,5 % |
| Fehlerhafte akzeptiert | eine unvollständige oder kaputte Zeichnung besteht | ≤ 10 % |
| Erkennung | das richtige Zeichen ist der erste Tipp | ≥ 85 % (Chinesisch ≥ 97 %) |
| Lehrbuch | eine exakte Lehrbuchzeichnung besteht | ≥ 99 % |
| Tempo | 95 % der Prüfungen beantwortet innerhalb von | 250 ms |
Diese Maße fließen auf TUNE in eine einzige Bewertung. Sie belohnt akzeptierte richtige Zeichnungen, gibt eine kleinere Belohnung für schlampige und zieht steile Strafen ab, sobald mehr als 2 % ähnliche Zeichen oder 10 % Fehler durchkommen. Ein Kandidat ersetzt das laufende Modell nur, wenn er diese Bewertung um mehr als 0,01 schlägt und auf HOLDOUT bei höchstens 0,5 % ähnlichen Zeichen bleibt. Sonst werden das alte Modell, seine Kalibrierung und seine Einstellungen Byte für Byte wiederhergestellt.
Diese Regel hat uns mehr als einmal schönere Zahlen gekostet. Ein größeres Netz für Latein, Griechisch und Kyrillisch (192 Kanäle, 60 Epochen) senkte die Fehler auf HOLDOUT auf 8–9 %, verlor aber auf TUNE. Wir haben das kleinere behalten. Die Größe des Netzes war nicht die Grenze.
Die Ergebnisse für jede Schrift
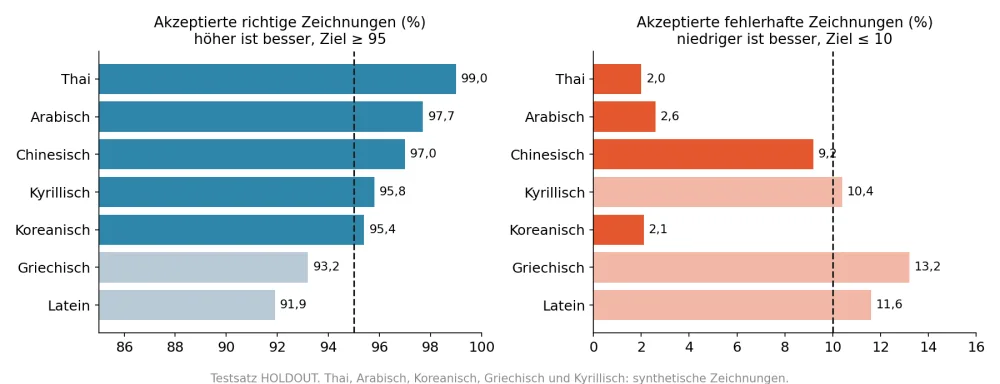
Ergebnisse auf HOLDOUT:
| Schrift | Zeichen | Richtige akzeptiert | Ähnliche akzeptiert | Fehlerhafte akzeptiert | Erkennung |
|---|---|---|---|---|---|
| Thai | 74 | 99,0 % | 0,1 % | 2,0 % | 99,3 % |
| Arabisch | 100 Formen | 97,7 % | 0 % | 2,6 % | 97,8 % |
| Chinesisch | 1.200 | 97,0 % | 0 % | 9,2 % | 97,6 % |
| Kyrillisch | 66 | 95,8 % | 0 % | 10,4 % | 98,2 % |
| Koreanisch | 924 Silben | 95,4 % | 0,1 % | 2,1 % | 95,5 % |
| Griechisch | 48 | 93,2 % | 0,4 % | 13,2 % | 94,1 % |
| Latein | 62 | 91,9 % | 0 % | 11,6 % | 90,4 % |
Für Thai, Arabisch, Koreanisch, Griechisch und Kyrillisch stammen die Testzeichnungen von unserer synthetischen Hand und einer Handvoll von Hand angefertigter Zeichnungen. Diese Zeilen solltest du als „wie gut der Prüfer mit den Händen umgeht, die wir simulieren können“ lesen.
Das Tempo war ein Thread-Problem, kein Modellproblem. Auf einer ausgelasteten Maschine startete die Standard-Rechenbibliothek von numpy für jede kleine Matrixmultiplikation einen vollen Satz Threads, und die stritten sich um die Kerne. Mit einem Thread pro Prozess fiel der Median einer Prüfung von 280–450 ms auf 42 ms für Latein, 60 ms für Griechisch und 101 ms für Chinesisch. Im Produktionsabbild fiel das 95. Perzentil für Latein von 76 ms auf 26 ms.
Was es noch nicht kann
- Thai hat noch keine echten thailändischen Hände gesehen. Alle seine Zahlen sind synthetisch. Das Bildnetz, das es ersetzt hat, lernte auf eingescannter thailändischer Handschrift, aber in unseren Tests gewinnt das Sequenznetz, und das läuft. Die Zeichnungen der Lernenden werden uns mehr verraten.
- Latein, Griechisch und Kyrillisch liegen unter dem Ziel. Am schwierigsten ist ein kurzer zusätzlicher Strich quer durch einen Buchstaben. Keine Messung trennt ihn von einer flüssigen Verbindung. Unsere TUNE-Sätze sind klein, also entscheiden einzelne Fälle über Vergleiche. Als Nächstes kommt ein größeres TUNE-Korpus.
- Chinesisch lässt noch einige Zeichnungen mit fehlendem Strich durch.
- Wir haben noch keine echten Zeichnungen von Lernenden. Mit ihrer Zustimmung werden sie zum wichtigsten Testsatz.
- Japanisch unterstützen wir noch nicht. Wir arbeiten daran. Kana sind der natürliche nächste Schritt, und Kanji teilen die meisten Striche mit dem Chinesischen.
Mehr darüber, wie Taalhammer Technologie und Lernforschung verbindet, findest du auf unseren Seiten Technologie und Wissenschaft.
FAQ
Läuft die Handschrifterkennung auf dem Handy?
Nein. Dein Handy schickt die Striche, und unsere Server prüfen sie in reinem numpy, ohne Grafikkarte. Eine Prüfung dauert 40–100 ms und fühlt sich deshalb sofort an.
Warum nicht ChatGPT oder ein anderes KI-Modell?
Wir haben es versucht. Ein großes Sprachmodell brauchte bis zu 4,4 Sekunden pro Zeichnung, jede Prüfung kostete Geld, und dieselbe Zeichnung bekam verschiedene Bewertungen. Ein kleines, spezialisiertes Netz ist schneller, kostet pro Prüfung nichts und gibt immer dieselbe Antwort.
Prüft sie die Strichreihenfolge?
Sie sieht Reihenfolge und Richtung jedes Strichs und nutzt sie für Hinweise. Eine Zeichnung lehnt sie wegen der Reihenfolge nie ab. Die Forschung zeigt nicht, dass eine bestimmte Reihenfolge beim Lernen hilft, und als die Reihenfolge zählte, wurden richtige Zeichnungen anderer Hände viel zu oft abgelehnt.
Mit welchen Daten wurde sie trainiert?
Mit echten Aufzeichnungen lateinischer Buchstaben (UNIPEN, UJI Pen Characters), Zeichnungen aus Omniglot, Strichdaten aus Make Me a Hanzi und offenen Schriftarten. Für die meisten Schriften stammen die Trainingszeichnungen von einer synthetischen Hand, die an echte Schrift angepasst ist.
Wie genau ist diese Handschrifterkennung?
In unseren HOLDOUT-Tests akzeptiert sie 95–99 % der richtigen Zeichnungen in Thai, Arabisch, Chinesisch, Kyrillisch und Koreanisch und 92–93 % in Latein und Griechisch. Ein ähnliches Zeichen akzeptiert sie fast nie (höchstens 0,4 %).